
ما هو ملف robots.txt وكيف تضبطه بنفسك
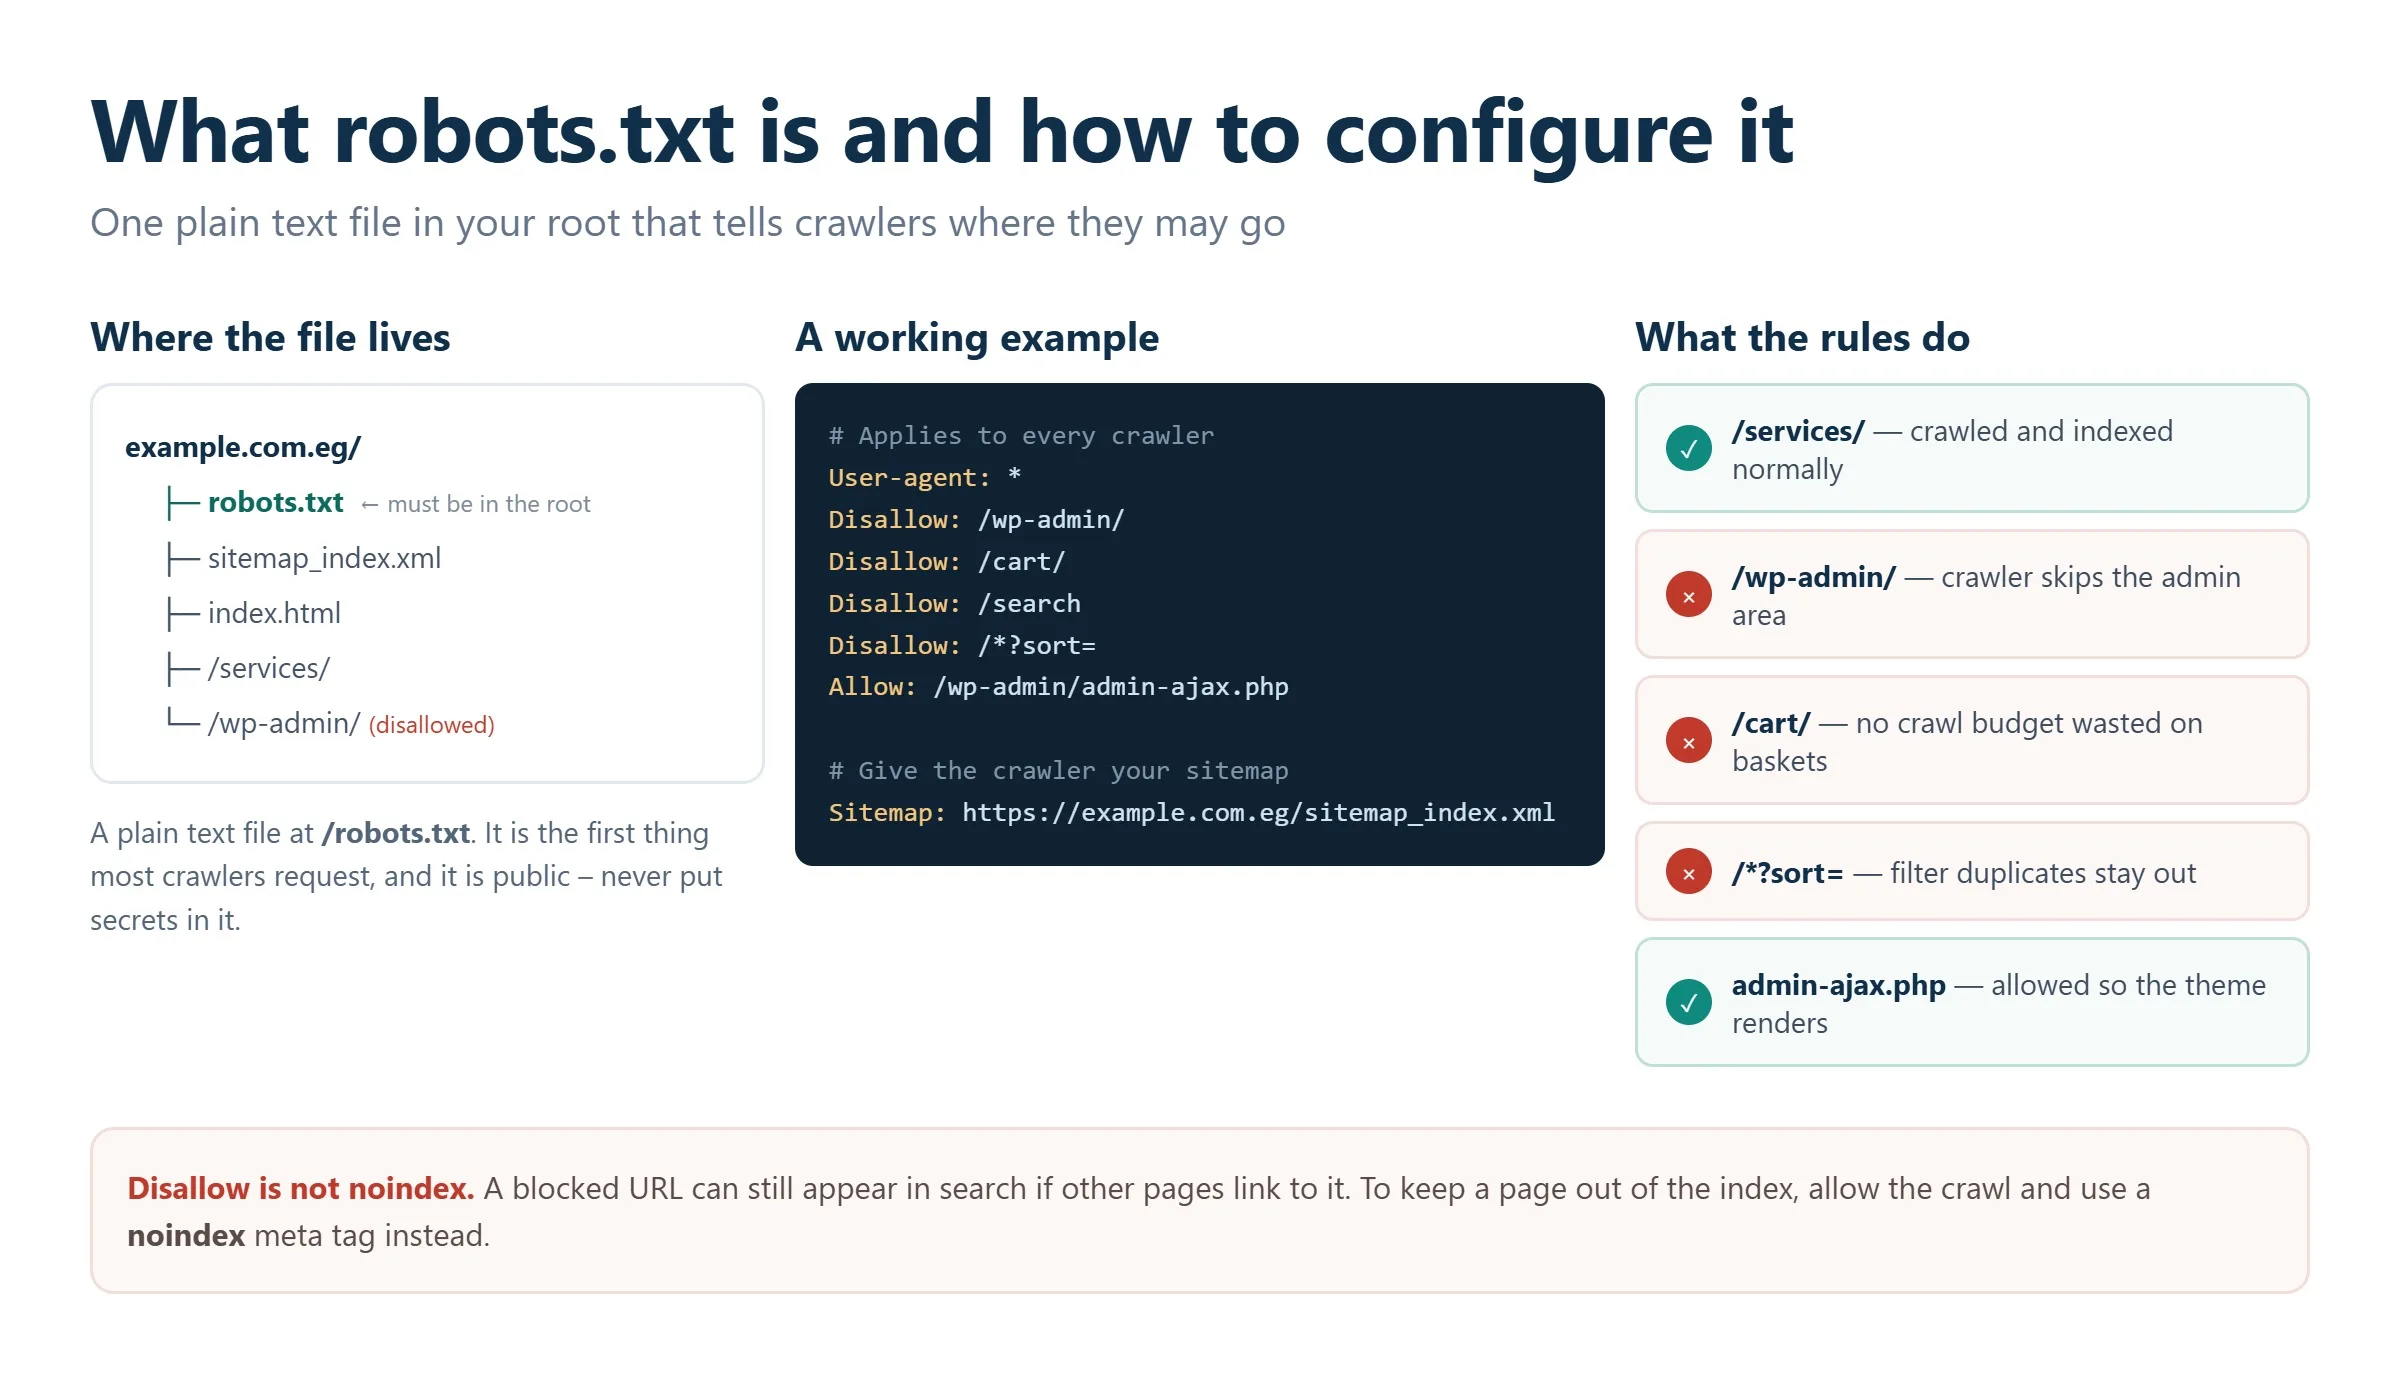
ملف robots.txt هو ملف نصي عادي يوضع في جذر نطاقك (على سبيل المثال، https://example.com/robots.txt) ويخبر زواحف محركات البحث مثل Googlebot بعناوين URL التي يُسمح لها بطلبها أو لا يُسمح. ويمكنك إعداده بنفسك بإنشاء ملف نصي بترميز UTF-8، وإضافة بضع تعليمات (User-agent, Disallow, Allow، و Sitemap)، ثم رفعه إلى المجلد الجذر والتحقق منه في Google Search Console. وهو يتحكم في الزحف لا في الفهرسة، لذا فهو جزء واحد من SEO التقني وليس مجموعة الأدوات كلها.
الخلاصة السريعة
- ملف robots.txt ملف عام في جذر نطاقك يقدّم تعليمات الزحف لروبوتات محركات البحث، ويجب أن يكون متاحًا على
/robots.txtوأن يكون مرمّزًا بـ UTF-8. - التعليمات الأربع التي ستستخدمها أكثر من غيرها هي
User-agent,Disallow,Allow، وSitemap. وتتيح لك أحرف البدل*و$مطابقة أنماط عناوين URL. - يتحكم ملف robots.txt في الزحف، وليس في الفهرسة. فقد تظهر الصفحة المحظورة في نتائج Google إذا كانت مواقع أخرى تضع روابط إليها. استخدم وسم
noindexمن نوع meta أو ترويسة HTTP لإبقاء الصفحة خارج الفهرس. - لا تحظر أبدًا ملفات CSS وJavaScript التي تحتاجها Google لعرض صفحاتك، ولا تنشر أبدًا عن طريق الخطأ التعليمة
Disallow: /فقد تقضي على زياراتك العضوية بالكامل. - اختبر التغييرات دائمًا باستخدام تقرير robots.txt وأداة فحص عنوان URL في Google Search Console قبل النشر وبعده.
ما هو ملف robots.txt ولماذا هو مهم
ملف robots.txt ملف نصي صغير يضع القواعد الأساسية للتعامل بين موقعك والزواحف الآلية. طُرح هذا المعيار لأول مرة عام 1994 باسم بروتوكول استبعاد الروبوتات (Robots Exclusion Protocol)، ثم اعتُمد رسميًا عام 2022 بوصفه RFC 9309 الذي شاركت Google في صياغته. ورغم أن حجمه لا يتجاوز بضعة كيلوبايتات، فهو من أوائل ما يطلبه الزاحف الملتزم عند زيارة موقعك.
إذا أُعدّ إعدادًا صحيحًا، يؤدي ملف robots.txt ثلاث مهام مفيدة:
- يدير ميزانية الزحف. يحدد عناوين URL منخفضة القيمة التي ينبغي للزواحف تجاهلها، مثل الفلاتر متعددة الأوجه ونتائج البحث الداخلي ومعاملات الجلسات، بحيث يقضي Googlebot وقته المحدود في الصفحات المهمة.
- يُبعد الفوضى عن مسار الزحف. يوجّه الروبوتات بعيدًا عن لوحات الإدارة وبيئات التجربة ومجلدات النظام.
- يرشد الزواحف إلى خريطة موقعك.
Sitemapهي التعليمة التي تساعد محركات البحث على اكتشاف عناوين URL المهمة لديك بسرعة أكبر.
المخاطر حقيقية. فقاعدة واحدة خاطئة قد تُخفي موقعًا كاملًا عن البحث. وفي واقعة يُستشهد بها كثيرًا، حظر ناشر كبير جميع مقالاته خطأً، فشهد انهيار زياراته العضوية بين عشية وضحاها تقريبًا. والملف المكتوب كتابةً صحيحة يشكّل أساسًا صامتًا لكل جزء آخر من استراتيجية SEO.
كيف تقرأ الزواحف الملف، وما حدوده
يوجد ملف robots.txt في جذر النطاق، ويجب تقديمه كملف نصي، ويُفضّل ألا يتجاوز حجمه 500 كيلوبايت، وهو الحد الذي تتوقف Google عنده عن القراءة. ويمكنك التأكد من عمله بكتابة عنوانه في المتصفح؛ فإذا ظهرت محتوياته، فالملف متاح.
ومن المهم بالقدر نفسه أن تفهم ما لا يستطيع ملف robots.txt فعله:
- لا يضمن بقاء الصفحة خارج Google. قد تُفهرس عناوين URL المحظورة إذا كانت مرتبطة من أماكن أخرى، وقد تعرضها Google دون وصف.
- لا يحمي المحتوى الخاص. الملف عام ويمكن لأي شخص قراءته، بمن في ذلك المنافسون. استخدم المصادقة لأي محتوى حساس فعلًا.
- لا يؤثر في الترتيب مباشرةً. السماح بالزحف إلى صفحة لا يعني أنها ستحقق ترتيبًا.
البنية والتعليمات الأساسية
يتبع ملف robots.txt قواعد صارمة سطرًا بسطر. وقد يؤدي حرف واحد في غير موضعه إلى تجاهل الزاحف لتعليمة ما، لذا فالدقة مهمة. إليك التعليمات التي ستستخدمها فعليًا.
User-agent: الزاحف الذي تنطبق عليه القواعد
تحدد هذه التعليمة الروبوت الذي كُتبت له مجموعة القواعد. استخدم * لمخاطبة جميع الزواحف، أو رمزًا محددًا لاستهداف زاحف بعينه.
User-agent: *          # applies to all crawlers
User-agent: Googlebot  # Google's main crawler only
User-agent: Bingbot    # Microsoft Bing's crawler only
إذا حذفت User-agent، تصبح المجموعة غير صالحة ويتجاهلها الزاحف. ويمكنك كتابة مجموعات منفصلة لروبوتات مختلفة.
Disallow: حظر الزحف إلى مسار
تطلب هذه التعليمة من الزاحف المحدد عدم طلب عناوين URL التي تبدأ بالمسار المذكور. والشرطة المائلة في البداية إلزامية.
Disallow: /admin/     # block the admin area
Disallow: /tmp/       # block temporary files
Disallow: /*?sort=    # block sort-parameter URLs
القيمة الفارغة، Disallow: دون أي شيء بعدها، تعني «السماح بكل شيء».
Allow: إنشاء استثناء
Allow تعيد فتح مسار محدد داخل قاعدة Disallow أوسع. وهي مفيدة عندما تريد حظر قسم مع إبقاء عنوان URL واحد قابلًا للزحف.
User-agent: *
Disallow: /blog/            # block the whole blog folder
Allow: /blog/seo-tips/      # but allow this one page
تحسم Google التعارض بالاعتماد على القاعدة المطابقة الأكثر تحديدًا (الأطول)، لذا فإن قاعدة Allow المستهدفة يمكنها تجاوز القاعدة الأعم Disallow.
Sitemap: الإشارة إلى خريطة موقع XML
أدرج عنوان URL كاملًا ومطلقًا واحدًا أو أكثر لخريطة الموقع. هذه التعليمة مستقلة عن User-agent وتساعد الزواحف على العثور على محتواك.
Sitemap: https://example.com/sitemap.xml
Sitemap: https://example.com/sitemap-images.xml
أحرف البدل والتعليقات
يمنحك رمزان خاصان إمكانية مطابقة الأنماط: * يمثّل أي تسلسل من الأحرف، و $ يثبّت نهاية عنوان URL. أما رمز # فيُستخدم لبدء تعليق.
# block every PDF file
Disallow: /*.pdf$

# block all internal search result pages
Disallow: /search?*
أمثلة جاهزة لـ WordPress وأنظمة إدارة المحتوى الأخرى
يعتمد الإعداد الصحيح على منصتك. فيما يلي قوالب عملية للبدء. عدّل المسارات لتناسب بنيتك الفعلية، واختبرها دائمًا قبل الاعتماد عليها.
WordPress
يستفيد موقع WordPress النموذجي من حظر نقاط نهاية الإدارة والنظام مع إبقاء الوسائط قابلة للزحف. وإذا كنت تستخدم WordPress، فإن فريق تطوير WordPress لدينا يمكنه إعداد ذلك إلى جانب إضافة SEO لديك.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /?s=                 # internal search results
Disallow: /comments/feed/
Allow: /wp-content/uploads/    # keep images and files crawlable

Sitemap: https://example.com/wp-sitemap.xml
لاحظ أن /wp-admin/admin-ajax.php مسموح به صراحةً لأن القوالب والإضافات تعتمد عليه، وأن /wp-content/uploads/ يبقى مفتوحًا حتى يمكن الزحف إلى الصور. وإذا كنت تستخدم Yoast أو إضافة SEO أخرى، فإنها تنشئ فهرسًا لخرائط الموقع (غالبًا sitemap_index.xml)، فأشر إليه بدلًا من ذلك.
متجر إلكتروني (Shopify وWooCommerce وما شابه)
تُنشئ المتاجر الإلكترونية أعدادًا هائلة من عناوين URL شبه المكررة عبر إجراءات سلة التسوق والحسابات والفلاتر. أزِلها من مسار الزحف.
User-agent: *
Disallow: /cart
Disallow: /checkout
Disallow: /account
Disallow: /*?sort=
Disallow: /*?filter=
Allow: /products/

Sitemap: https://shop.example.com/sitemap.xml
موقع متعدد اللغات
أبقِ مناطق الإدارة المخصصة لكل لغة مغلقة، وتأكد من أن لكل لغة خريطة موقع مستقلة.
User-agent: *
Disallow: /en/admin/
Disallow: /de/admin/

Sitemap: https://example.com/sitemap-en.xml
Sitemap: https://example.com/sitemap-de.xml
غالبًا ما تُنشئ الأسواق الإلكترونية الكبيرة ومنصات SaaS ملف robots.txt ديناميكيًا حتى تظل القواعد متوافقة مع بنية عناوين URL المتغيرة، وهي مهمة تستحق أن تُسندها إلى فريق الدعم الفني.
الأخطاء الشائعة وكيفية إصلاحها
حتى المطورون ذوو الخبرة يقعون في أخطاء في ملف robots.txt، وقد تكون التكلفة باهظة. انتبه لما يلي.
- حظر كامل غير مقصود.
Disallow: /ضمنUser-agent: *تطلب من كل زاحف تجاهل موقعك بالكامل. وهذا هو السبب الكلاسيكي للانهيار المفاجئ في الزيارات بعد الإطلاق أو النقل. - حظر ملفات CSS وJavaScript. إذا لم يتمكن Googlebot من جلب الموارد التي يحتاجها لعرض الصفحة، فقد يُسيء تقدير التصميم ومدى ملاءمتها للجوال. أبقِ موارد العرض قابلة للزحف.
- إغفال الشرطة المائلة في البداية.
Disallow: adminليس مسارًا صالحًا؛ اكتبDisallow: /admin/. - الاعتماد على robots.txt لإزالة صفحة من Google. لأن الصفحة المحظورة قد تُفهرس عبر الروابط الواردة، فاستخدم بدلًا من ذلك
noindex(انظر أدناه). - أخطاء حالة الأحرف والمسافات. يجب أن يكون اسم الملف بأحرف صغيرة
ملف robots.txt، والمسافات الزائدة بعد النقطتين قد تعطّل التحليل لدى الزواحف الأشد صرامة.
كلما ورثت موقعًا أو أجريت عليه إصلاحًا شاملًا، فإن تدقيق SEO ينبغي أن يشمل مراجعة ملف robots.txt لاكتشاف هذه المشكلات قبل أن تكلّفك ترتيبك.
الفرق بين robots.txt وnoindex ووسم meta robots
هذه أكثر نقطة يُساء فهمها في SEO التقني، لذا تستحق الدقة.
- robots.txt يتحكم في الزحف. يحدد ما إذا كان مسموحًا للروبوت بطلب عنوان URL. ويعمل على مستوى الموقع أو المجلد.
-
noindexوسم meta robots (أو ترويسةX-Robots-Tagفي HTTP) يتحكم في الفهرسة. يطلب من Google عدم الاحتفاظ بالصفحة في فهرسها. ويعمل على مستوى الصفحة الفردية.
التفاعل الحاسم: إذا حظرت صفحة في robots.txt، فلن تزحف Google إليها أبدًا، ما يعني أنها لن ترى أبدًا وسم noindex في تلك الصفحة. لذا فإن الصفحة المحظورة والمُعلَّمة في الوقت نفسه بـ noindex قد تبقى في الفهرس على نحو متناقض. ولضمان إزالة عنوان URL، اسمح بالزحف وأضف noindex، أو استخدم أداة إزالة عناوين URL في Search Console. يبدو الوسم البسيط على مستوى الصفحة هكذا:
<meta name="robots" content="noindex, follow">أما الملفات غير HTML مثل ملفات PDF، فاستخدم لها الترويسة المكافئة:
X-Robots-Tag: noindexباختصار: استخدم robots.txt لتوفير ميزانية الزحف على عناوين URL منخفضة القيمة، واستخدم noindex لإبقاء صفحات محددة خارج نتائج البحث. فهما يحلّان مشكلات مختلفة وغالبًا ما يعملان معًا.
كيفية اختبار robots.txt في Google Search Console
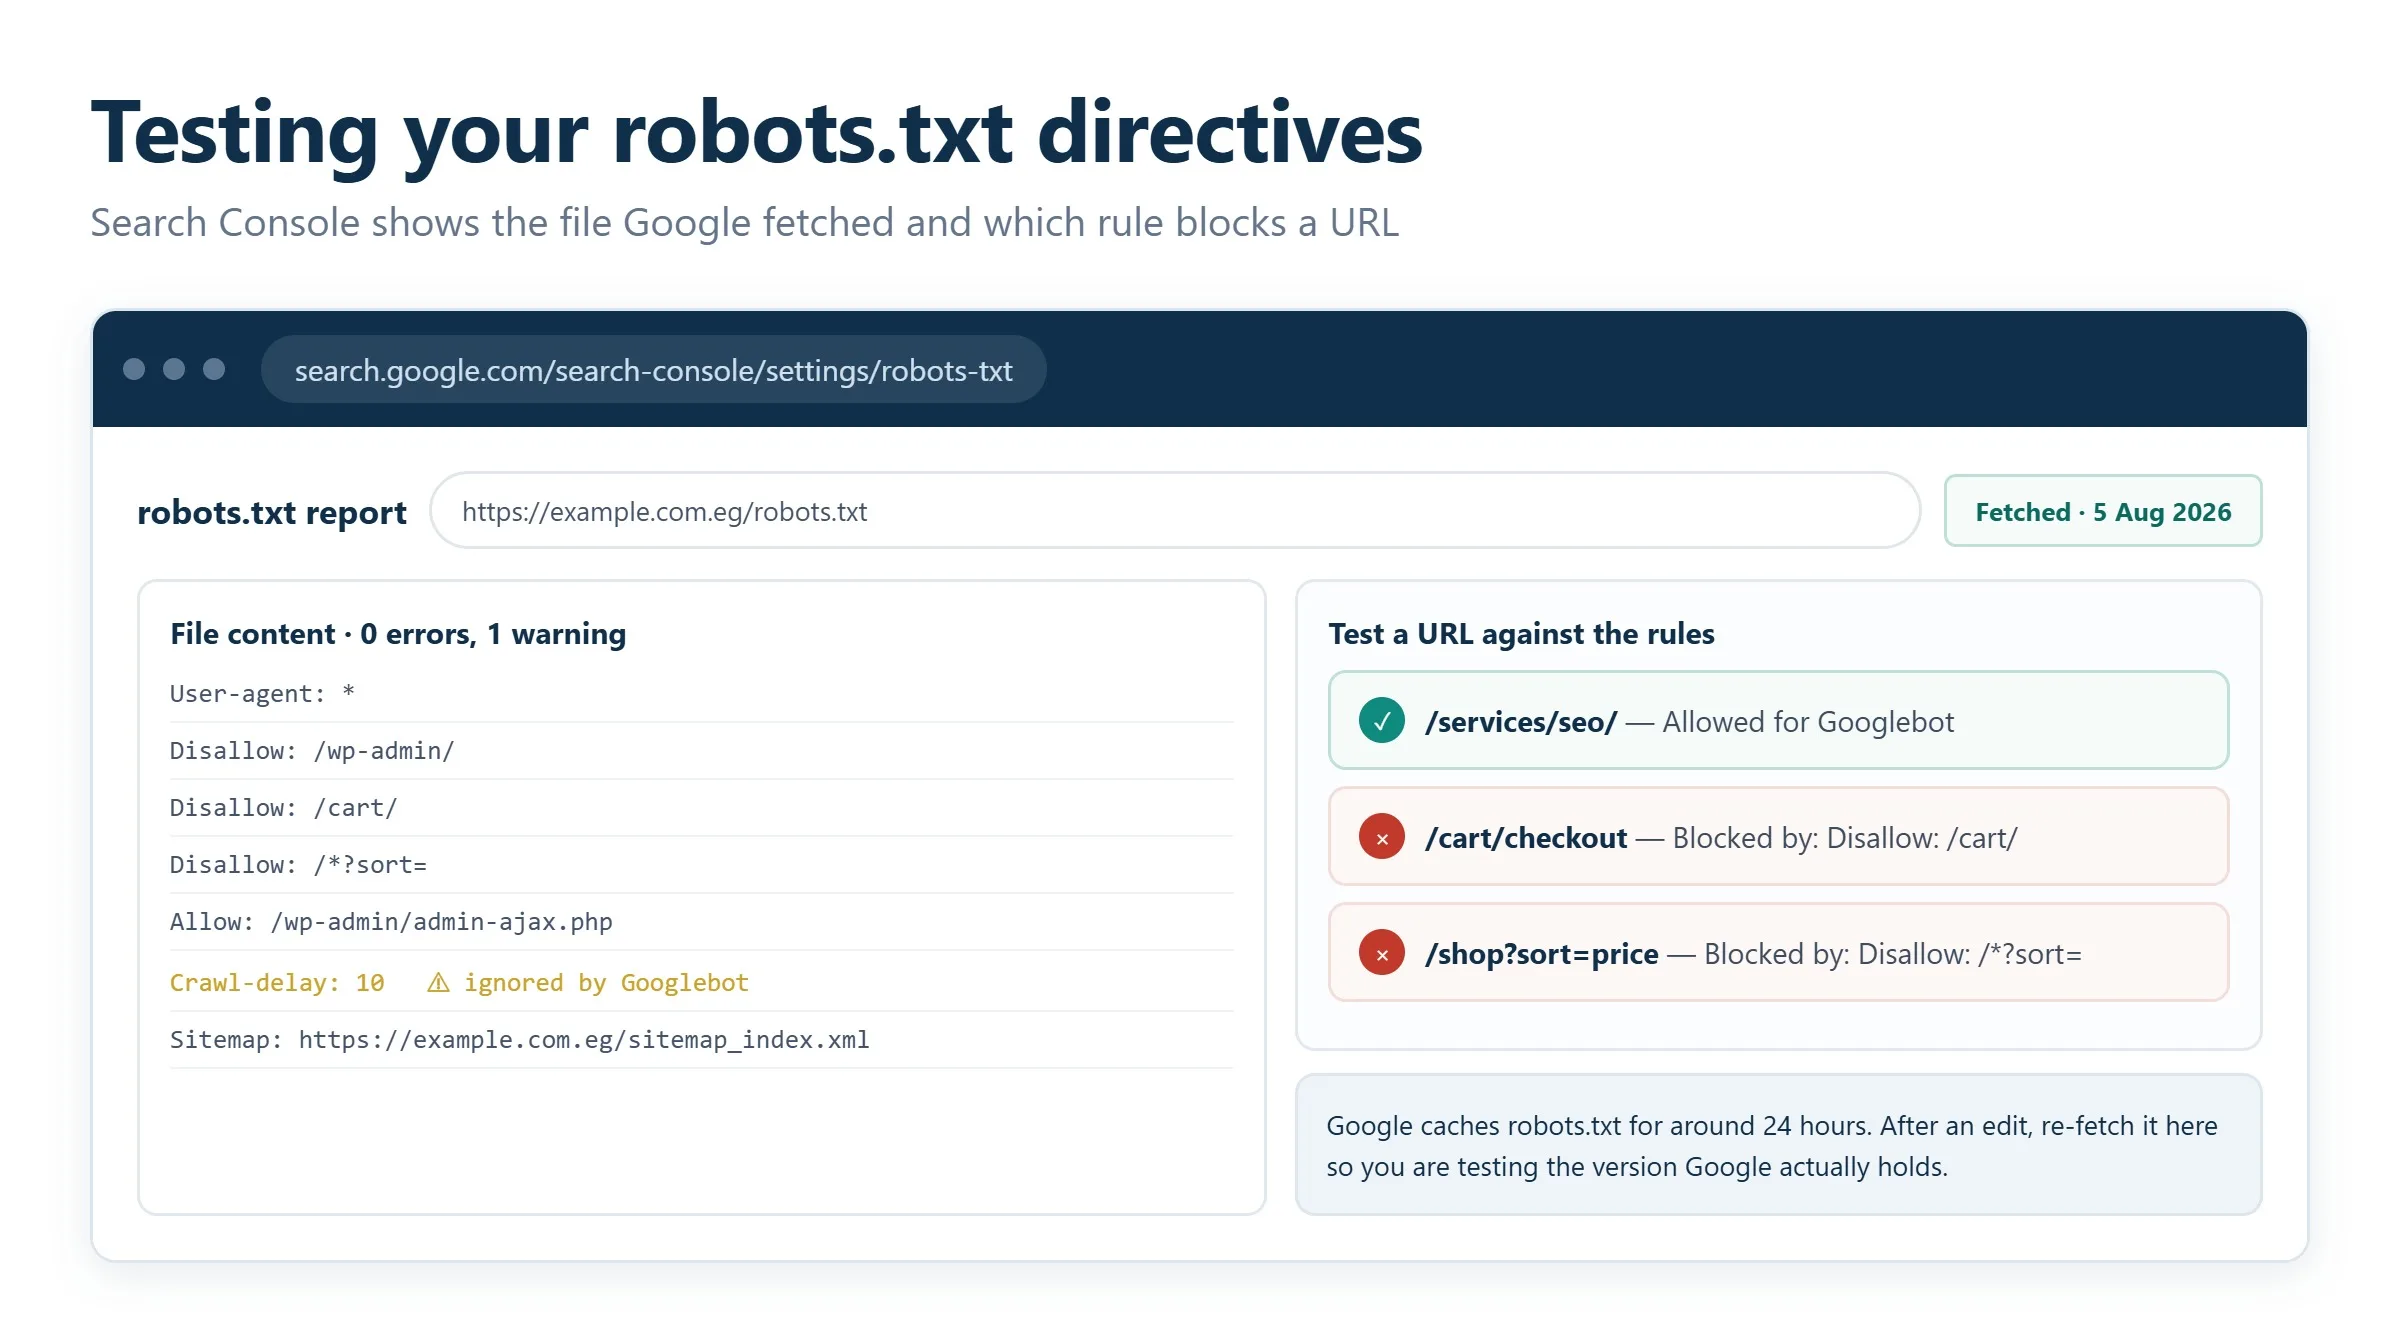
لا تنشر أبدًا تغييرًا على robots.txt دون تحقق. إذ يمنحك Google Search Console الأدوات اللازمة لرؤية الملف كما يراه Googlebot.
- افتح تقرير robots.txt. في Search Console، انتقل إلى الإعدادات ← robots.txt. تعرض Google النسخة التي جلبتها آخر مرة، وتوقيت جلبها، وتنبّه إلى أي أخطاء أو تحذيرات في التحليل.
- اطلب إعادة الجلب بعد التغييرات. إذا رفعت ملفًا جديدًا للتو، فاستخدم الخيار المتاح في التقرير لتطلب من Google جلب أحدث نسخة حتى تتوقف عن استخدام نسخة مخزنة مؤقتًا.
- اختبر عناوين URL محددة باستخدام فحص عنوان URL. الصق عنوان URL في شريط الفحص أعلى Search Console. ستعرف ما إذا كان robots.txt يسمح بالصفحة أو يحظرها، وما إذا كانت مفهرسة.
- أعد الفحص بعد التعديلات. تأكد من أن الصفحات التي تريد فهرستها قابلة للزحف، وأن عناوين URL التي قصدت حظرها محظورة فعلًا، وأنه لم يُحظر أي شيء آخر عن طريق الخطأ.
اجعل ذلك عادة: أجرِ الفحص بعد كل إعادة تصميم أو نقل لنظام إدارة المحتوى أو تغيير هيكلي، وراجع الملف مرة واحدة على الأقل كل ربع سنة. ومع تحوّل البحث نحو محركات الإجابة المدعومة بالذكاء الاصطناعي، فإن الانضباط نفسه في بناء أسس تقنية نظيفة وقابلة للزحف يشكّل أيضًا أساس تحسين محركات البحث التوليدية .
أسئلة شائعة
هل أحتاج إلى ملف robots.txt أصلًا؟
ليس بالضرورة. فإذا لم يكن لديك ملف robots.txt، تفترض الزواحف أنها تستطيع الوصول إلى كل شيء، وهذا مناسب لكثير من المواقع الصغيرة. ومع ذلك، يتيح لك وجوده إدارة ميزانية الزحف والإشارة إلى خريطة موقعك وإبعاد الروبوتات عن مجلدات النظام، لذا تستفيد معظم المواقع من ملف مدروس وبسيط بدلًا من عدم وجوده.
هل تؤدي تعليمة Disallow إلى إزالة الصفحة من نتائج بحث Google؟
لا. Disallow تمنع Google من الزحف إلى الصفحة، لكن عنوان URL قد يظل يظهر في النتائج إذا كانت صفحات أخرى تضع روابط إليه. ولضمان إزالة الصفحة، اسمح بالزحف وأضف وسم noindex من نوع meta أو ترويسة X-Robots-Tag أو استخدم أداة الإزالة في Google Search Console.
أين يوضع ملف robots.txt بالضبط؟
يجب أن يكون في جذر نطاقك وأن يكون متاحًا على https://yourdomain.com/robots.txt. لا يُعترف بالملف الموضوع في مجلد فرعي. ويحتاج كل نطاق فرعي إلى ملف robots.txt خاص به، ويجب أن يكون اسم الملف بأحرف صغيرة بالكامل.
هل يمكنني وضع قواعد مختلفة لـ Googlebot والزواحف الأخرى؟
نعم. اكتب مجموعة User-agent منفصلة لكل زاحف تريد معاملته معاملةً مختلفة، مثل مجموعة لـ Googlebot وأخرى لـ Bingbot. يتبع الزاحف المجموعة الأكثر تحديدًا التي تذكره بالاسم، ولا يلجأ إلى مجموعة User-agent: * إلا إذا لم تذكره أي مجموعة مباشرة.
كم مرة يجب أن أراجع ملف robots.txt؟
راجعه مرة واحدة على الأقل كل ربع سنة، ودائمًا بعد إعادة التصميم أو نقل المنصة أو أي تغيير في بنية عناوين URL. وتحقق من تقرير robots.txt في Search Console ومن سجلات الخادم للتأكد من أن الزواحف تقضي وقتها في الصفحات الصحيحة.
أدلة ذات صلة
هل تريد أن يصل
المزيد من الناس إلى موقعك؟
مكالمة استراتيجية
وتدقيق كامل للموقع

اقرأ أيضًا

مقال Bing’s AI Performance Report: What Gulf and Egyptian Brands Can See About Copilot Citations

مقال Google تنقل ملخصات الذكاء الاصطناعي لبحث العلامات التجارية إلى الجانب: ما الذي يجب أن تتابعه العلامات في الشرق الأوسط الآن

مقال كيف تظهر في ChatGPT ويرشّح شركتك في إجاباته؟
مقال اسمك في ChatGPT: سمعة الأفراد والتنفيذيين في الذكاء الاصطناعي
مقال كم تكلفة SEO في مصر والسعودية والإمارات في 2026؟
مقال ما المواقع التي تستشهد بها محركات الذكاء الاصطناعي؟ ماذا تعني دراسة شملت 288 إجابة للعلامات الخليجية
نتائج حقيقية
المزيد من النجاحات
SEO وGEO لـ Delta Medical Labs
 GEO
أكثر من مليون زيارة عضوية شهريًا، 159,200 كلمة مفتاحية في نتائج البحث، 5,570 صفحة يستشهد بها الذكاء الاصطناعي، و 1,186 ترتيبًا في المركز الأول بالسعودية.
SEO عربي وGEO ونشر مقالات الضيوف لـ VPNly
 SEO
65 ألف زيارة عضوية شهرية في الذروة، 55 مقال ضيف، و 149 صفحة يستشهد بها الذكاء الاصطناعي.
SEO وGEO لـ Ogaei Virtual Care
GEO
من 3 إلى 7,931 نقرة عضوية شهريًا خلال 7 أشهر، أكثر من 2.9 مليون ظهور، و أكثر من 40 كلمة مفتاحية في أفضل 10 نتائج على Google.
SEO لـ Eduverse
SEO
12× زيادة في زيارات البحث خلال 10 أشهر، 45% من الكلمات المستهدفة في أفضل 5 نتائج، و 55% في أفضل 10 نتائج.
شركات تثق بنا