
دراسة: تحسين البحث بالذكاء الاصطناعي في الشرق الأوسط: فجوة الاستشهاد بالمحتوى العربي
- #AIOverviews
- #AIsearchoptimization
- #ArabicSEO
- #ChatGPT
- #GenerativeEngineOptimization
- #MENASEO
للعربية أكثر من 400 مليون متحدث، والإمارات صاحبة أعلى معدل تبنٍّ للذكاء الاصطناعي التوليدي في العالم. ومع ذلك تمثل العربية 0.6% من صفحات Common Crawl. هذا التباين بين عدد من يطرحون الأسئلة على مساعدات الذكاء الاصطناعي في الخليج وضآلة المادة العربية المتاحة لتلك المساعدات لتستشهد بها هو الفرصة الحاسمة في التسويق الرقمي في منطقة الشرق الأوسط وشمال أفريقيا الآن. تحدد هذه الدراسة ما يتضمنه تحسين الظهور في البحث بالذكاء الاصطناعي في الشرق الأوسط فعلًا، وأي الأرقام منشورة بالفعل، وأيها لم يقسه أحد بعد.
الخلاصة السريعة
- تحتل الإمارات المركز الأول عالميًا في تبنّي الذكاء الاصطناعي التوليدي بنسبة 70.1%، مقابل متوسط عالمي يبلغ 17.8% (معهد Microsoft لاقتصاد الذكاء الاصطناعي، مايو 2026). وتحتل قطر المركز العاشر بنسبة 41.8%.
- العربية تمثل 0.6677% من أحدث Common Crawl، والإنجليزية 40.45%، أي أكبر بنحو 61 مرة (إحصاءات اللغات في Common Crawl، CC-MAIN-2026-34).
- أنظمة الاسترجاع متعددة اللغات تُخفّض ترتيب المصادر العربية. فالاستعلامات العربية تسجّل ما بين 28.9 و33.8 في مقياس الاستدعاء على مستوى الثلاثيات الحرفية مع أدوات إعادة الترتيب القياسية، مقابل ما بين 51.4 و53.6 مع الأدلة المثالية، أي عجز من 18 إلى 21 نقطة (معهد البرمجيات، الأكاديمية الصينية للعلوم، أبريل 2026).
- ليس للعربية الفصحى أي متحدث أصلي، ولها 335 مليون مستخدم لغةً ثانية (Ethnologue 28). الناس يسألون باللهجة، والنماذج تجيب بالفصحى، ومحتواك يجب أن يخدم الاثنين.
- المعايير المترجمة تجمّل صورة النماذج، والعربية الأصلية تكشف الفجوة الحقيقية. فقد سجّل GPT-4 نسبة 72.5% على ArabicMMLU الأصلي مقابل 80% مُبلغ عنها على MMLU المترجم (MBZUAI، فبراير 2024)، ولهذا باتت كل المختبرات التي تضع العربية أولًا تدرّب نماذجها على بيانات أصلية لا مترجمة آليًا.
- لا تقيس أي من دراسات لغة الاستشهاد الكبيرة المنشورة حتى الآن تركيب لغة المصادر في استشهادات البحث بالذكاء الاصطناعي للاستعلامات العربية. وحتى أغسطس 2026، لم يُعثر على مثل هذا القياس.
مشكلة 70/0.6
يملك الخليج أعلى طلب في العالم على إجابات الذكاء الاصطناعي، وأحد أضعف مخزونات المادة المصدرية للإجابة عنها. سمّها مشكلة 70/0.6: تبنٍّ بنسبة 70.1% في الإمارات، وحصة للعربية لا تتجاوز 0.6% من الويب الذي شمله الزحف. فكل استعلام عربي يتلقاه مساعد يجب أن يُجاب عنه من رصيد نصي بالكاد يمثل اللغة التي طُرح بها.
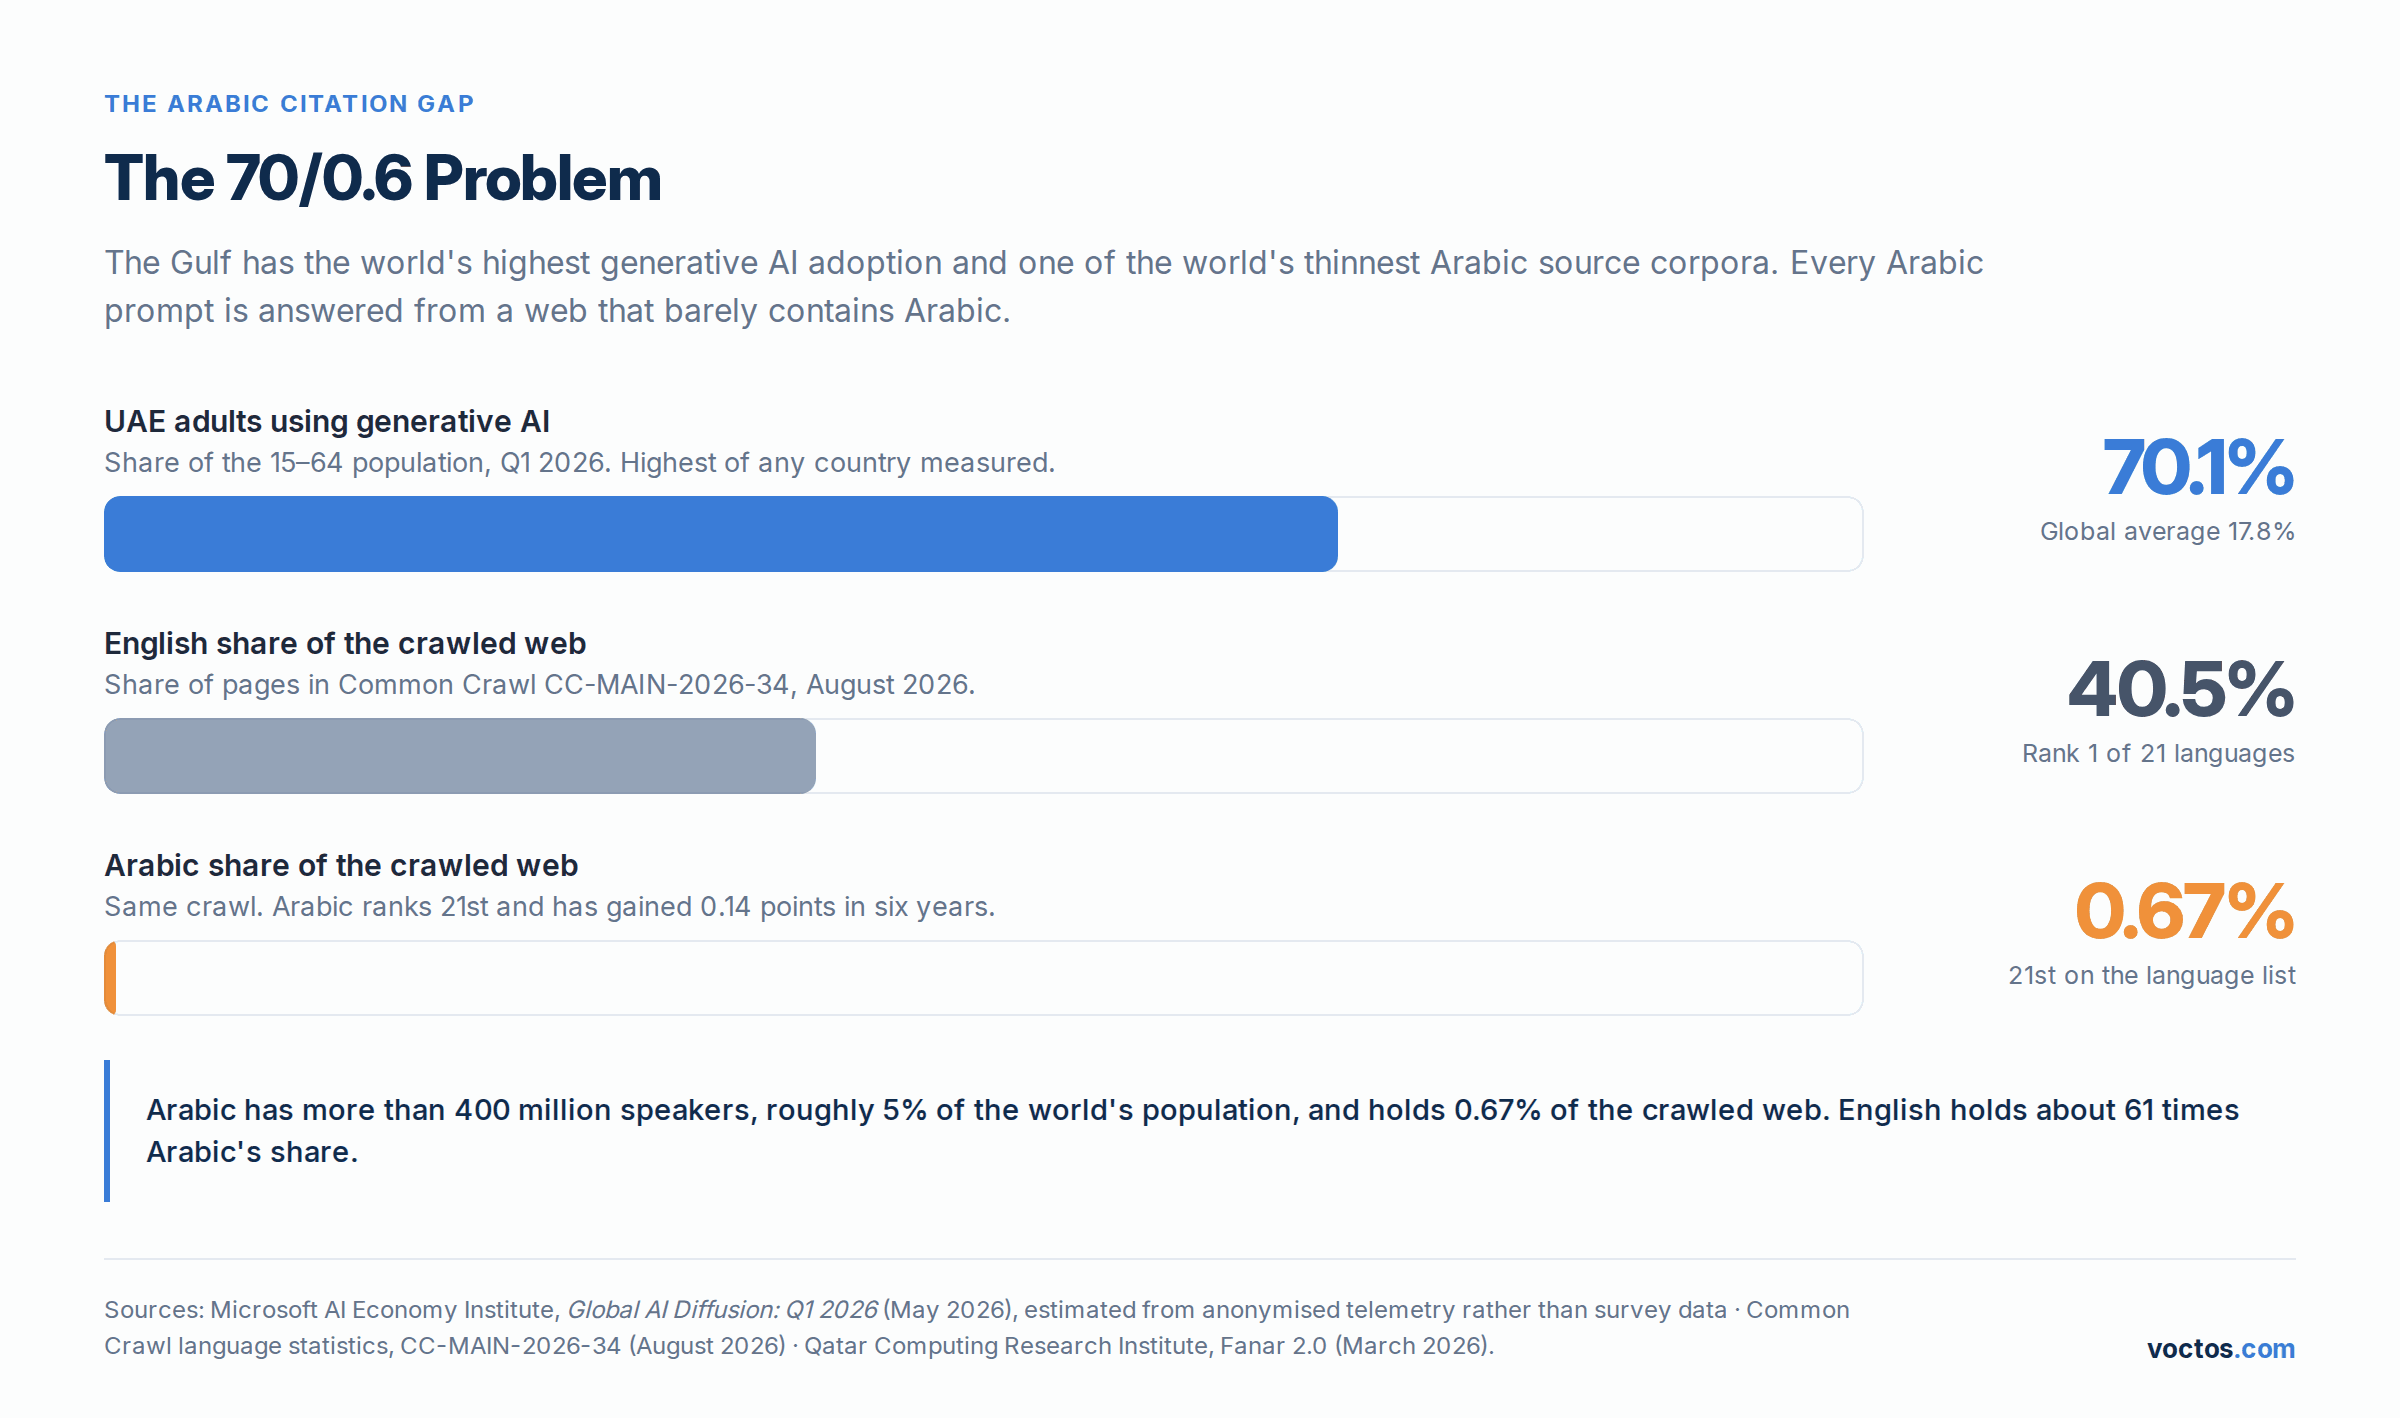
جانب الطلب موثق، وهو لافت للغاية. يضع معهد Microsoft لاقتصاد الذكاء الاصطناعي الإمارات في المركز الأول عالميًا بنسبة 70.1% في تقريره عن انتشار الذكاء الاصطناعي عالميًا للربع الأول من 2026، متقدمةً على سنغافورة (63.4%)، وبأكثر من ضعف نسبة الولايات المتحدة (31.3%). وتقف قطر في المركز العاشر بنسبة 41.8%، والسعودية عند 29.4%، والأردن 29.7%، وعُمان 26.5%، والكويت 21.1%. والمتوسط العالمي 17.8%. وتقدّر Microsoft التبنّي من بيانات قياس عن بُعد مجهولة الهوية لا من استطلاعات، لذا تعامل مع الأرقام المطلقة على أنها مؤشرات اتجاه، لكن الترتيب متسق عبر الإصدارات، وقد حافظت الإمارات على المركز الأول منذ النصف الأول من 2025.
وتؤكد الجهة التنظيمية السعودية الاتجاه نفسه بمنهجية مختلفة تمامًا. فقد أفادت هيئة الاتصالات والفضاء والتقنية في تقرير الإنترنت السعودي الخامس، المنشور في 19 يوليو 2026، بأن 45.2% من مستخدمي الإنترنت السعوديين يستخدمون الآن أدوات الذكاء الاصطناعي، أي أكثر من ضعف نسبة العام السابق. وChatGPT هو تطبيق الذكاء الاصطناعي الأكثر تنزيلًا في المملكة، يليه Google Gemini وDeepSeek ومنصة HUMAIN الوطنية. ويبلغ الاستخدام ذروته عند 55.7% في الفئة العمرية 20 إلى 29 عامًا، وتستخدم النساء أدوات الذكاء الاصطناعي أكثر من الرجال، 52.8% مقابل 39.4%.
ووجد استطلاع Deloitte لاتجاهات المستهلك الرقمي 2026، الذي شمل 1,000 مستهلك سعودي، أن 66% يستخدمون أدوات الذكاء الاصطناعي بنشاط، بزيادة 17 نقطة مئوية خلال عام. وكانت أشيع حالات الاستخدام البحث عن المعلومات، بنسبة 51%. فالأمر لا يتعلق بالإنتاجية، بل بإحلال الذكاء الاصطناعي محل البحث، وقد قيس ذلك مباشرةً.
ويضع ترتيب Similarweb لشهر يوليو 2026 موقع chatgpt.com في المركز الثالث بين أكثر المواقع زيارةً في الإمارات، بعد google.com وyoutube.com فقط. ويحتل المركز السادس في قطر، والسابع في السعودية، والثامن في الكويت ومصر.
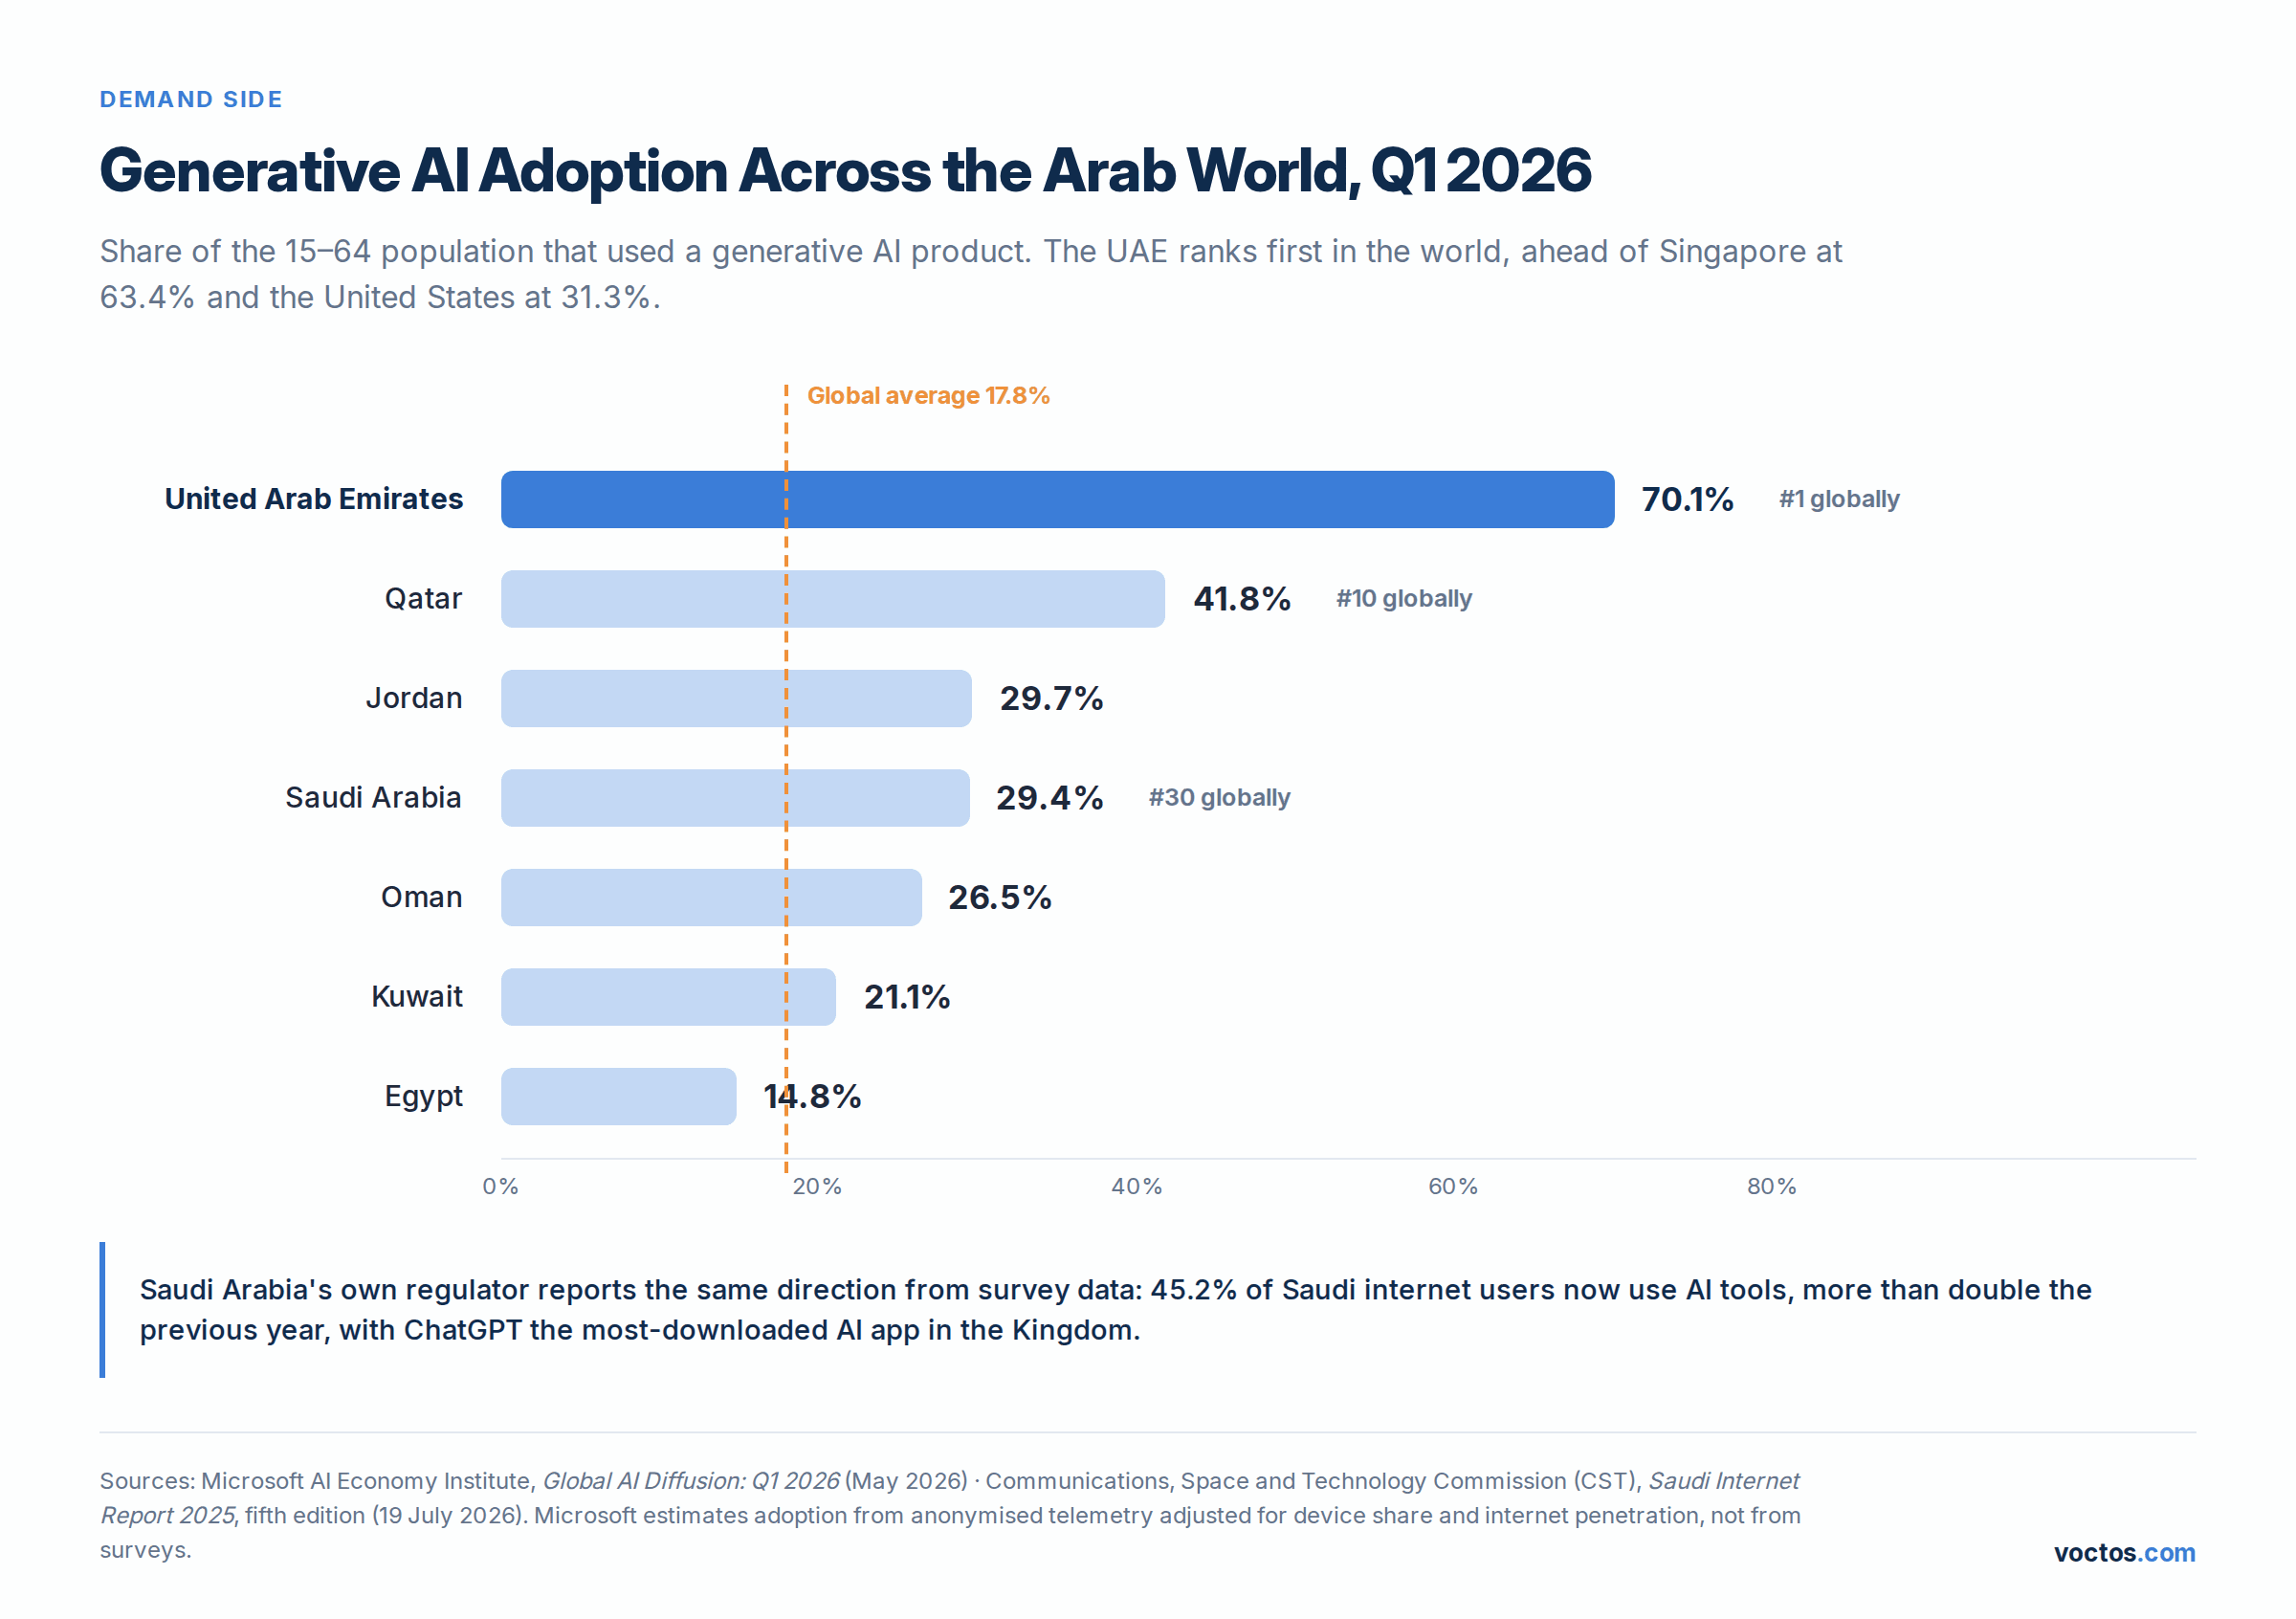
والآن جانب العرض. تُظهر إحصاءات اللغات المنشورة من Common Crawl لـ CC-MAIN-2026-34 وجود 14,286,482 صفحة عربية، أي 0.6677% من الزحف. وتمثل الإنجليزية 865,530,140 صفحة، أي 40.4526%. وتأتي العربية في المركز الحادي والعشرين في القائمة، أو العشرين بين اللغات المحددة بعد استبعاد فئة غير مصنفة. وقد بقيت حصتها ثابتة تقريبًا لست سنوات، من 0.5307% في مطلع 2020 إلى 0.6677% الآن. وتصل W3Techs، التي تقيس مجموعة مختلفة من المواقع، إلى الإجابة نفسها تقريبًا: العربية لغة محتوى 0.6% من المواقع، مقابل 49.5% للإنجليزية.
ضع ذلك مقابل قاعدة متحدثي العربية. يصنّف Ethnologue العربية خامس أكثر اللغات تحدثًا في العالم، ويضعها معهد قطر لبحوث الحوسبة عند أكثر من 400 مليون متحدث أصلي. ومقابل عدد سكان عالمي يقارب 8.2 مليار، فهذا يعني أن نحو 5% من البشرية يملكون 0.67% من الويب المفهرس، أي نقص تمثيل بنسبة سبعة إلى واحد تقريبًا.
وقد عبّر معهد قطر لبحوث الحوسبة عن القيد بوضوح في ورقة Fanar 2.0 المنشورة في مارس 2026، مشيرًا إلى أن «المحتوى العربي يمثل نحو 0.5% فقط من بيانات الويب»، بوصف ذلك مشكلة تصميم جوهرية اضطر إلى الالتفاف عليها هندسيًا. وكتب فريق Jais 2 في MBZUAI وInception وCerebras في يوليو 2026 أن العربية «لا تزال ممثلة تمثيلًا ناقصًا في بيانات التدريب العالمية»، وأن النماذج العامة مثل Llama 3 وGemma وQwen 2.5 «لا تحقق سوى إتقان جزئي للعربية».
من يبنون النماذج اللغوية العربية يقولون إن رصيد المحتوى العربي صغير جدًا. ومن ينشرون بالعربية لم يدركوا بعد ما يعنيه ذلك لهم.
ما الذي يحدث حين يطرح أحدهم سؤالًا على مساعد ذكاء اصطناعي بالعربية
الاستعلام العربي لا يُجاب عنه ببساطة من مصادر عربية. فالثابت أن أنظمة الاسترجاع تفضّل المستندات الإنجليزية والمكتوبة بالحروف اللاتينية، وتكبت المصادر العربية حتى حين تحتوي على الإجابة الأفضل. وهذا سلوك مقيس ومنشور، لا تخمين.
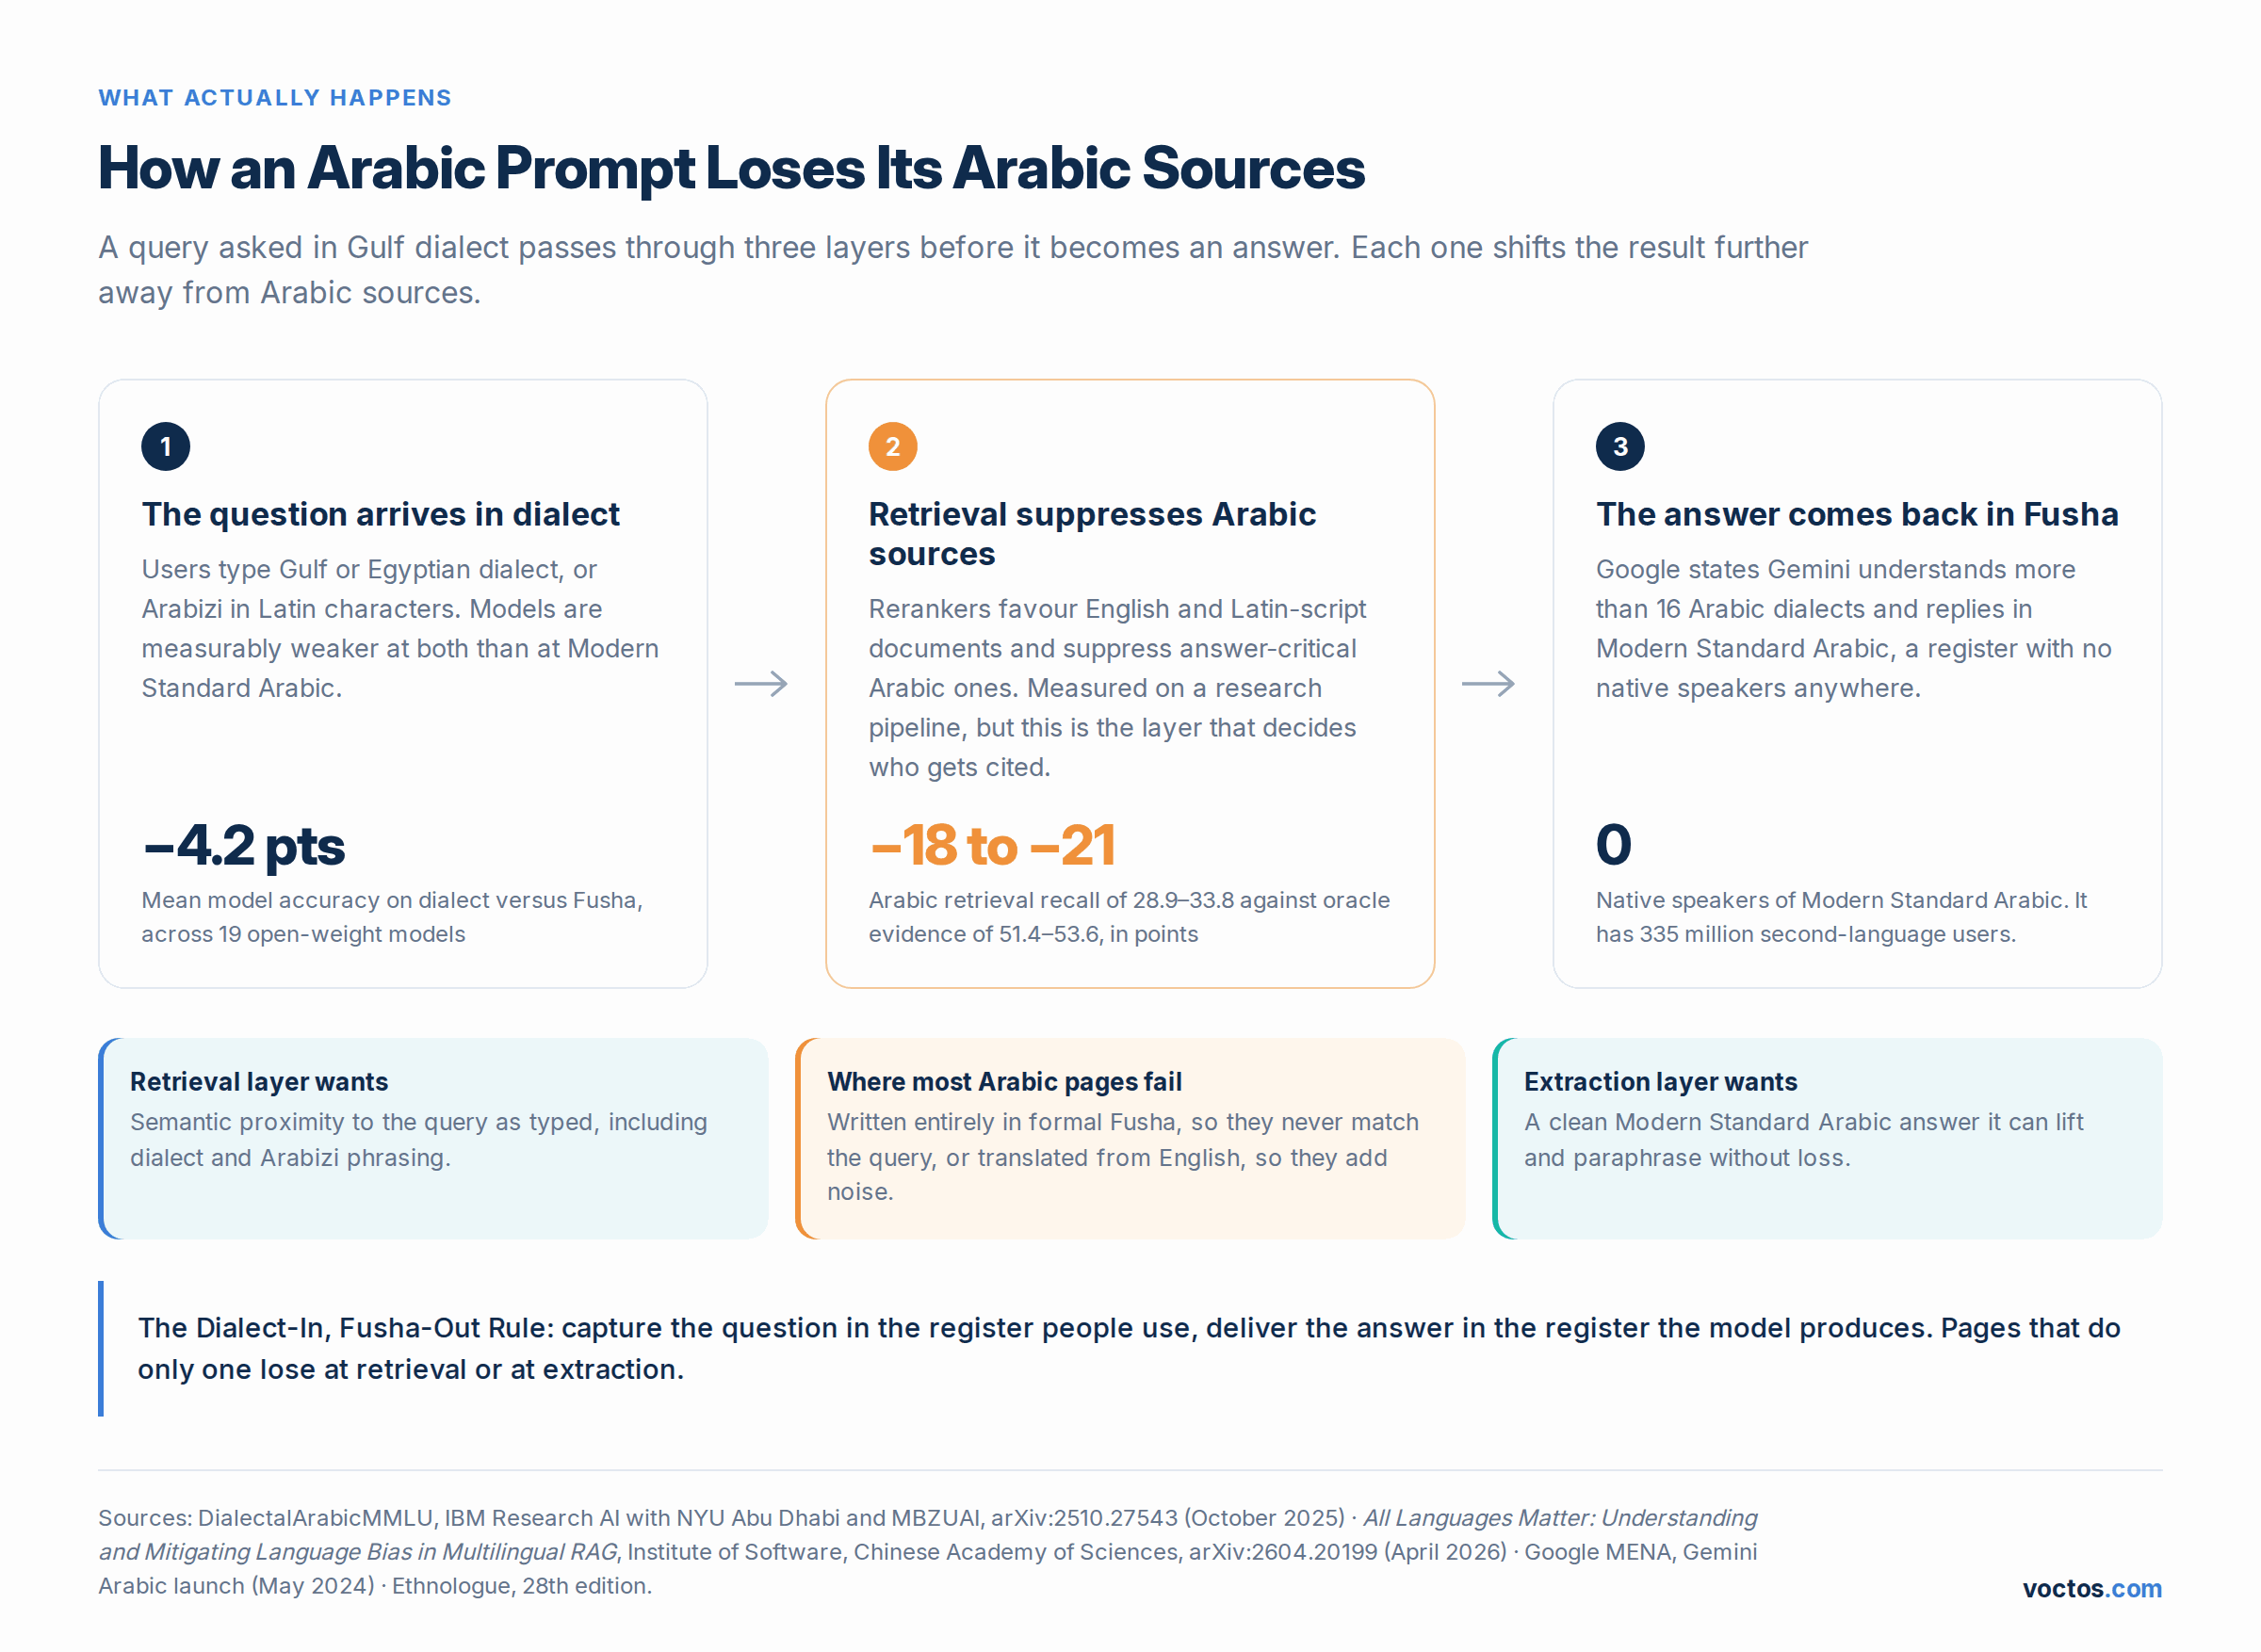
أوضح دليل يأتي من معهد البرمجيات في الأكاديمية الصينية للعلوم، في دراسة منشورة في أبريل 2026 عن الانحياز اللغوي في التوليد المعزز بالاسترجاع متعدد اللغات. فعبر 13 لغة، جاء أكثر من 70% من أفضل خمس وثائق مسترجعة من الإنجليزية أو من لغة الاستعلام وحدها. أما في العربية تحديدًا، فبلغ استدعاء الثلاثيات الحرفية من 32.7 إلى 33.8 مع أداة إعادة الترتيب BGE، ومن 28.9 إلى 31.4 مع Qwen3. ومع الأدلة المثالية، أي أفضل الوثائق المتاحة فعلًا بغض النظر عن اللغة، بلغ المقياس نفسه من 51.4 إلى 53.6. أي عجز في الاسترجاع من 18 إلى 21 نقطة. ووجد الباحثون أن الأدلة المفيدة «موزعة عبر لغات متعددة لا تهيمن عليها لغة واحدة»، ومع ذلك فإن أدوات إعادة الترتيب «تكبت هذه الوثائق الحاسمة للإجابة كبتًا منهجيًا». ومن المهم ملاحظة النطاق: هذا مسار استرجاع بحثي على معيار مفتوح، لا قياس لأي منتج تجاري للبحث بالذكاء الاصطناعي.
ووجدت دراسة منفصلة من جامعة تشونغ آنغ، منشورة في Findings of ACL 2025، النمط نفسه من زاوية مختلفة. فأدوات الاسترجاع تُظهر تفضيلًا قويًا للغات ذات الموارد الوفيرة، والإنجليزية في مقدمتها. والمولّدات تفضّل اللغات المكتوبة بالحروف اللاتينية على غيرها، مما يضع الخط العربي في الجانب الخطأ من الفجوة. وسجّلت العربية 40.39 في مقياسهم لتحوّل الترتيب أحادي اللغة مع BGE-m3، مقابل أرقام إنجليزية تتجاوز 56 غالبًا. ويشير الباحثون إلى أن هذه التفضيلات لا تحسّن جودة الإجابة باستمرار، أي أن الانحياز لا يبرر وجوده.
وتحت ذلك كله تفسير على مستوى الآلية الداخلية. فقد وجدت أبحاث من EPFL منشورة في 2024 أن نماذج Transformer متعددة اللغات تفك ترميز الرمز التالي الصحيح دلاليًا في طبقاتها الوسطى، لكنها تمنح «احتمالًا أعلى لنسخته الإنجليزية منه بلغة المدخلات» قبل الانتقال إلى منطقة خاصة بلغة المدخلات. ففضاء المفاهيم المجردة، بتعبير الباحثين، «أقرب إلى الإنجليزية منه إلى اللغات الأخرى». وقد درس ذلك العمل Llama-2 ولم يعزل العربية، فاقرأه على أنه آلية لا قياس عربي.
وتؤكد Google الشكل العملي لهذا اللاتماثل في منتجها. فحين أضاف Gemini دعم العربية في مايو 2024، ذكرت Google أن النموذج يفهم الأسئلة بأكثر من 16 لهجة عربية ويقدّم إجاباته بالعربية الفصحى. اللهجة مدخلًا، والفصحى مخرجًا. وهذا القرار التصميمي الواحد يحدد كل شيء في طريقة استرجاع المحتوى العربي والاستشهاد به.
دراسة واحدة تتناول سلوك الاستشهاد العربي مباشرةً. فقد حللت Profound 3.25 مليار استشهاد، جُمعت في مارس 2026 ونُشرت في أبريل، عبر 14 دولة و10 لغات منها العربية. وفي السوقين الإماراتي والسعودي، أظهرت AI Overviews من Google ما سمّاه الباحثون انقلابًا شبه كامل عن خط الأساس الإنجليزي: وصلت استشهادات Instagram إلى 29%، وتراجع YouTube إلى 26% وفقد مركزه الأول المعتاد تمامًا، وتضاعف LinkedIn تقريبًا. وProfound تبيع برمجيات للظهور في الذكاء الاصطناعي، لذا فهذه دراسة مزود بمنهجية مُفصح عنها لا عمل محكّم، لكنها مجموعة البيانات الكبيرة الوحيدة التي تشمل الأسواق العربية أصلًا.
وإليك، بصراحة، حدود ما هو معروف حتى الآن. توجد دراستان كبيرتان أخريان عن لغة الاستشهاد، من Temso AI في أبريل 2026 وWeglot في أغسطس 2026، ولا تشمل أيٌّ منهما العربية. تغطي Temso الإسبانية والهولندية والألمانية والسويدية والإيطالية والفرنسية، وتغطي Weglot الإنجليزية والفرنسية والإسبانية واليابانية. ولم يُعثر لهذا المقال على أي قياس منشور لتركيب لغة المصادر في استشهادات البحث بالذكاء الاصطناعي للاستعلامات العربية. فإن ذكر لك أحدهم نسبة مئوية لذلك، فاسأله من أي دراسة جاءت.
قاعدة «اللهجة مدخلًا، والفصحى مخرجًا»
ينقسم سلوك البحث العربي عبر ثلاثة مستويات لغوية لا يضطر أي سوق كبير آخر إلى التوفيق بينها. فالناس يكتبون استعلاماتهم باللهجة أو بالعربيزي، والنماذج في أقوى حالاتها بالفصحى، والنماذج تجيب بالفصحى بغض النظر عن طريقة وصول السؤال. والمحتوى الذي لا يخدم إلا مستوى واحدًا يخسر إما في الاسترجاع أو في الاستخراج.
ابدأ بحقيقة تفاجئ معظم المسوقين: العربية الفصحى ليس لها متحدثون أصليون. يُدرج Ethnologue الفصحى بصفر متحدثين بها لغةً أولى و335 مليون مستخدم لها لغةً ثانية، لأن الناطقين بالعربية يتعلمون لهجة محلية أولًا ثم يكتسبون الفصحى عبر التعليم الرسمي. فالمستوى اللغوي الذي حُسّنت النماذج اللغوية لإنتاجه ليس لغة أم لأحد.
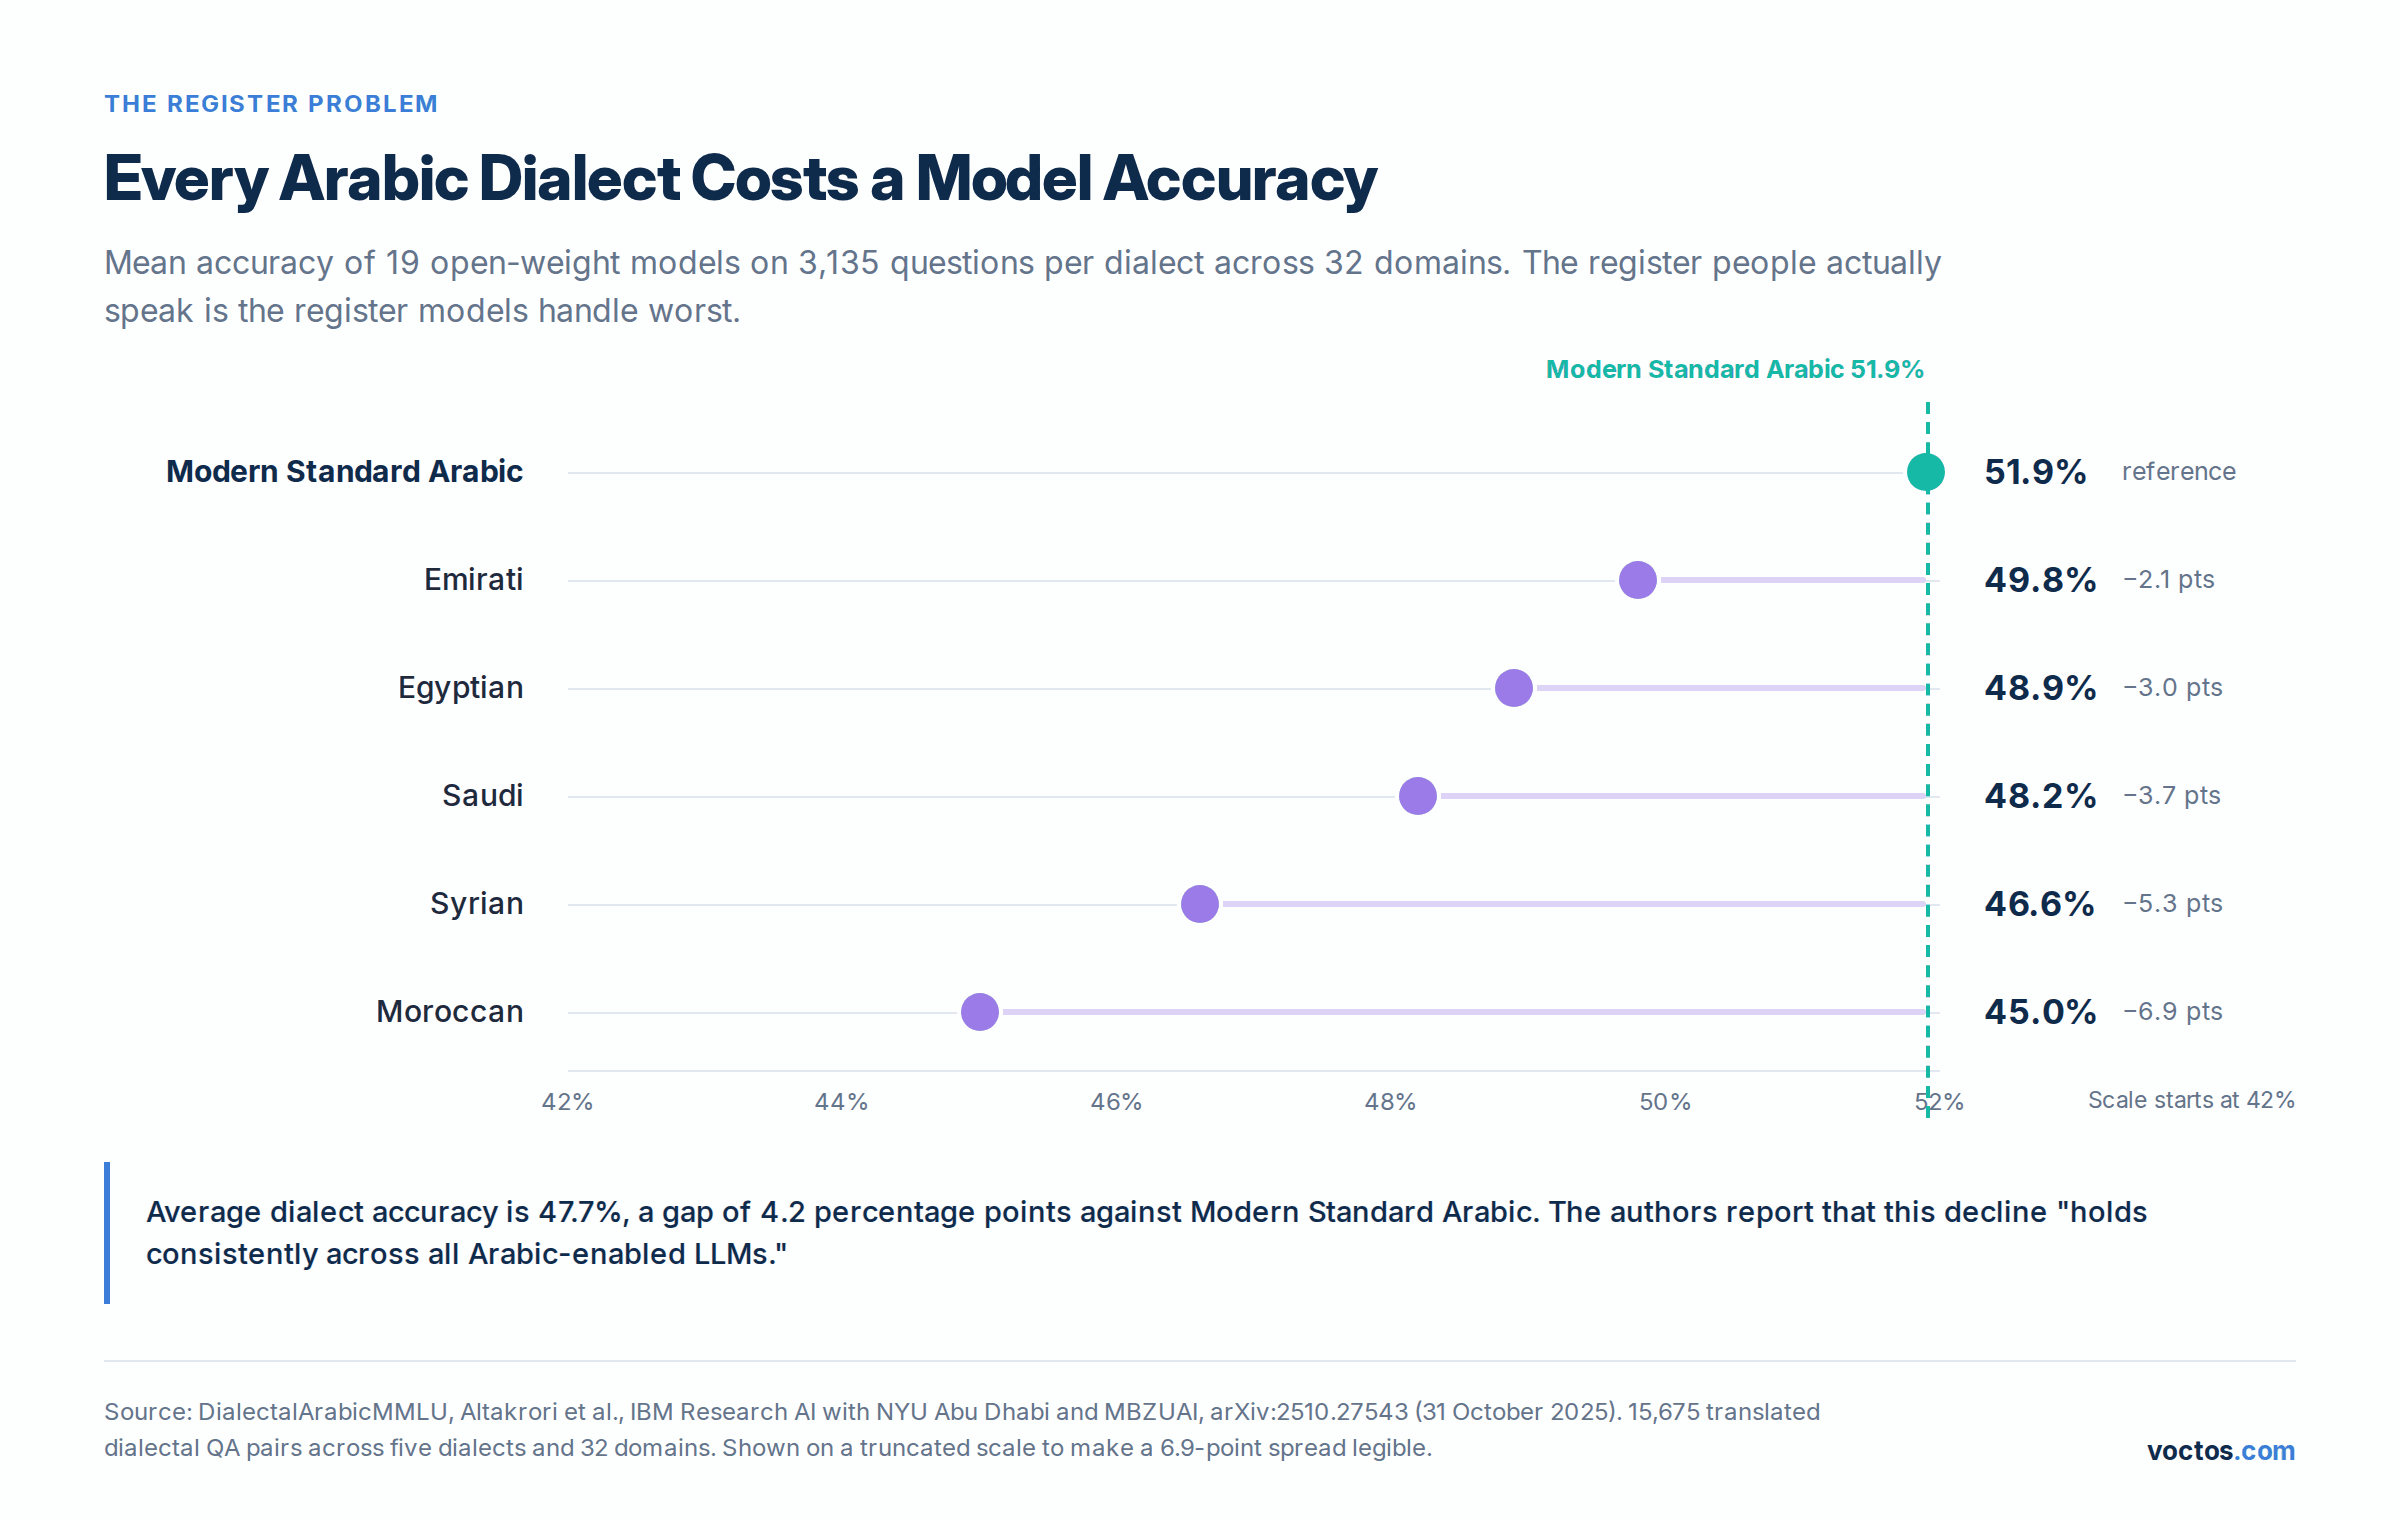
تكلفة اللهجة على الأداء مقيسة. فمعيار DialectalArabicMMLU، الذي نشرته IBM Research AI مع جامعة نيويورك أبوظبي وMBZUAI في أكتوبر 2025، اختبر 19 نموذجًا مفتوح الأوزان على 3,135 سؤالًا لكل لهجة عبر 32 مجالًا. وبلغ متوسط الدقة 51.9% بالفصحى و47.7% عبر اللهجات، أي فجوة 4.2 نقطة مئوية. وحسب اللهجة: الإماراتية 49.8%، والمصرية 48.9%، والسعودية 48.2%، والسورية 46.6%، والمغربية 45.0%. وأفاد الباحثون بأن الأداء «ينخفض باستمرار عبر جميع اللهجات مقارنةً بالفصحى والإنجليزية، وهذا الاتجاه ثابت عبر جميع النماذج اللغوية الداعمة للعربية».
ويُظهر معيار AraDiCE من QCRI الانحدار نفسه في فهم المقروء. فقد سجّل Llama-3-8B-Instruct دقة 0.85 بالإنجليزية، و0.74 بالفصحى، و0.71 بالشامية، و0.73 بالمصرية. ووجد العمل نفسه أن الترجمة من اللهجة إلى الإنجليزية تتفوق باستمرار على الترجمة من الإنجليزية إلى اللهجة، أي أن النماذج تفهم اللهجات أفضل مما تولّدها.
والعربيزي أسوأ. فقد اختبر باحثون في جامعة جنيف سبعة نماذج على النقل الحرفي للعربية باللاتينية (الفرانكو) في 2025. سجّل GPT-4o، الأفضل أداءً، درجة BLEU من 17.39 إلى 20.16 في ترجمة العربيزي إلى الإنجليزية، لكن من 8.40 إلى 10.15 فقط في ترجمتها إلى العربية. وبالمتوسط عبر النماذج السبعة، انخفضت الدرجات حسب اللهجة: المصرية 9.65، واللبنانية 7.52، والجزائرية 4.24. ونسبة كبيرة من الشباب في الخليج والشام تكتب بالعربيزي، والنماذج تتعامل معها بالعربية بنحو نصف كفاءتها في الإنجليزية.
القاعدة التي تترتب على ذلك سهلة القول ونادرة التطبيق: التقط السؤال بالمستوى اللغوي الذي يستخدمه الناس، وقدّم الإجابة بالمستوى اللغوي الذي ينتجه النموذج.
عمليًا، يعني ذلك أن الصفحة العربية تحمل صياغات لهجية وعربيزية في طبقة الأسئلة فيها، أي في عناوين H2 وبنود الأسئلة الشائعة واللغة الطبيعية للأسطر الافتتاحية، ليجد الاسترجاع الدلالي ما يطابقه مع استعلام حقيقي. أما الإجابة نفسها فتُكتب بفصحى سليمة، لأنها ما يتقن النموذج تحليله وما سينتجه حين يعيد صياغة كلامك. والصفحات المبنية كليًا بالفصحى الرسمية تفوّت الاستعلام، والصفحات المبنية كليًا باللهجة تُسترجع ثم تُستخرج استخراجًا ضعيفًا. ويجب أن يحضر النصفان معًا.
لماذا لا تنجح ترجمة محتواك الإنجليزي إلى العربية
العربية المترجمة والعربية الأصلية ليستا مدخلين قابلين للتبادل في نظام استرجاع. فكل معيار يفصل بينهما يُظهر أن المحتوى المترجم يجمّل أداء النماذج بينما يكشف المحتوى الأصلي الفجوة الحقيقية، وقد استجابت المختبرات التي تبني النماذج العربية باستبعاد الترجمة الآلية من بيانات تدريبها كليًا.
أوضح دليل في ورقة ArabicMMLU من MBZUAI، فبراير 2024. فقد سجّل GPT-4 نسبة 72.5% على ArabicMMLU، المبني من 14,575 سؤالًا عربيًا أصليًا مأخوذة من مناهج حقيقية في ثماني دول. ويعطي التقرير التقني لـ GPT-4 نسبة 80% على MMLU المترجم من الإنجليزية إلى العربية. ويعزو مؤلفو ArabicMMLU فجوة النقاط الثماني إلى احتواء مجموعة بياناتهم على «نسبة أعلى من المحتوى الخاص بالعربية».
اقرأ هذه النتيجة مرتين، لأنها الحجة كلها. فالعربية المترجمة تقيس ما إذا كان النموذج يستطيع التعامل مع مفاهيم إنجليزية مصاغة بكلمات عربية، أما العربية الأصلية فتقيس ما إذا كان يستطيع التعامل مع مفاهيم عربية ومراجع عربية وأطر عربية. والثانية هي ما يسأل عنه عملاؤك فعلًا، وهي حيث تكون النماذج أضعف والمحتوى الجيد أندر.
ووصل معهد الابتكار التكنولوجي في أبوظبي إلى الاستنتاج نفسه من جانب النموذج. فحين بنى TII نموذج Falcon Arabic في مايو 2025، درّبه على ما وصفه بـ «مجموعات بيانات عربية أصلية بنسبة 100%»، متجنبًا صراحةً المحتوى المترجم آليًا، وأضاف 32,000 رمز خاص بالعربية إلى مفرداته. وبنى Jais 2 مفردات مخصصة من 150,272 رمزًا للسبب نفسه. وهذه قرارات هندسية مكلفة اتُّخذت تحديدًا لأن العربية المترجمة لم تكن جيدة بما يكفي.
وهناك سبب إضافي للاهتمام بجودة المصادر العربية. فقد نشر باحثون في جامعة الملك سعود وجامعة الأمير سطام بن عبدالعزيز ومعهد الإدارة العامة في الرياض معيارًا لمتانة RAG العربي أمام التشويش في مجلة Frontiers in Big Data في 17 أغسطس 2026، اختبروا فيه ستة نماذج عبر 300 سؤال و6,196 وثيقة. فعند انعدام التشويش، سجّل Claude-4 Sonnet 91.67% وGPT-4o 74.33%. وعند تشويش بنسبة 80%، تراجع Claude-4 Sonnet 4.67 نقطة مئوية فقط إلى 87.00%، بينما انخفض GPT-4o إلى 61.00%، أي تراجع بـ 13 نقطة.
اقرأ ذلك على أنه تفاوت بين النماذج لا مقارنة مع الإنجليزية، إذ لم تختبر الدراسة اللغة الإنجليزية أصلًا. والنقطة العملية صامدة في الحالتين: فالمصادر العربية التي تُسترجع إلى جانب مصادرك تغيّر الإجابة تغييرًا جوهريًا، وفي بعض النماذج تغيّرها بأكثر من 13 نقطة. وفي رصيد محتوى يمثل 0.67% من الويب ومحشوّ بكثافة بالترجمة الآلية، تضيف العربية المترجمة الضعيفة تشويشًا إلى مجموعة استرجاع مشوّشة أصلًا، وهذا التشويش يُضعف الإجابة التي تظهر فيها علامتك التجارية.
الموقف الذي يتبناه هذا المقال، وهو رأي وليس محل إجماع: على معظم العلامات التجارية الخليجية التي تُنتج محتواها بالإنجليزية أولًا أن تتوقف عن الترجمة وتبدأ بتكليف كتّاب بإعداد محتوى أصلي. فحجم أصغر من المحتوى العربي المكتوب بأقلام ناطقين بالعربية،عن واقع السوق العربي، بأرقام ولوائح وأمثلة خاصة بالخليج، سيتفوق على نسخة مترجمة كاملة من الموقع الإنجليزي. فالنسخة المترجمة تنافس في فئة تتعامل معها النماذج أصلًا، أما المحتوى العربي الأصلي فينافس في الفئة التي تعاني فيها من شحّ البيانات.
كن مؤهلًا قبل أن يُستشهد بك
معظم المواقع الخليجية تُخفق في البحث بالذكاء الاصطناعي بسبب الأهلية، لا جودة المحتوى. فثلاث أدوات تحكم تقنية تحدد ما إذا كان المساعد يستطيع رؤية صفحاتك أصلًا، واثنتان منها تغيرتا خلال 2026 بطرق لم تواكبها معظم الإرشادات المنشورة.
الأولى هي فصل زواحف OpenAI، وكثيرًا ما يُساء فهمها. فـ OAI-SearchBot هو الوكيل الذي يُظهر المواقع في ميزات البحث في ChatGPT، وGPTBot يزحف إلى المحتوى الذي قد يُستخدم في تدريب النماذج. وهما إعدادان مستقلان. حجب GPTBot لإبقاء محتواك خارج التدريب لا يؤثر في ظهورك في ChatGPT Search. أما حجب OAI-SearchBot فيُخرجك من إجابات البحث في ChatGPT، وإن كانت OpenAI تشير إلى أن هذه الصفحات قد تظل تظهر روابطَ تنقّل. وكثير من مواقع المنطقة التي أضافت حجبًا شاملًا لروبوتات الذكاء الاصطناعي في 2024 غير مرئية حاليًا في ChatGPT ولا تعلم ذلك.
وتغيّر أمران هنا مؤخرًا. ففي 9 ديسمبر 2025، أزالت OpenAI الصياغة التي تُلزم ChatGPT-User، الوكيل الذي يجلب الصفحات حين يطلبها المستخدم، بالامتثال لملف robots.txt. وأي دليل يقول إن كل روبوتات OpenAI تحترم robots.txt بات خاطئًا الآن. كما أضافت OpenAI الوكيل OAI-AdsBot، الذي يتحقق من سلامة الصفحات التي تُقدَّم إعلاناتٍ على ChatGPT، ولا يكاد يظهر في أي قائمة زواحف منشورة.
والأداة الثانية هي التي لا يتحقق منها أحد في المنطقة. فدليل Google الرسمي لتحسين الظهور في الذكاء الاصطناعي التوليدي، المحدَّث آخر مرة في 10 يوليو 2026، ينص على أنه «إضافةً إلى المتطلبات التقنية للبحث، يجب تضمين الموقع في ميزات الذكاء الاصطناعي التوليدي للبحث في Search Console ليكون مؤهلًا للعرض في ميزات الذكاء الاصطناعي التوليدي في بحث Google». وهذه بوابة حقيقية بثلاثة إعدادات: التضمين، والاستبعاد، والوراثة من الأصل، وتغطي AI Overviews وAI Mode والذكاء الاصطناعي التوليدي في Discover. وصياغة Google نفسها صريحة: المواقع التي تنسحب «لن تتلقى زيارات أو مرات ظهور من ميزات الذكاء الاصطناعي التوليدي لدينا». وأُطلقت هذه الأداة لمواقع المملكة المتحدة في يونيو 2026 تحت ضغط تنظيمي، وكانت لا تزال تُطرح لدول أخرى خلال يوليو. تحقق مما إذا كانت مفعّلة على خاصيتك قبل أن تفترض أن الإعداد الافتراضي سارٍ.
وثمة خرافة مرتبطة بها ينبغي تفنيدها صراحةً. فحجب Google-Extended لا يُخرجك من AI Overviews أو AI Mode. تقول Google بوضوح إن «Google-Extended لا يؤثر في تضمين الموقع في بحث Google ولا يُستخدم إشارةً للترتيب في بحث Google». فهو يتحكم فقط في تطبيقات Gemini وفي الإسناد إلى المصادر (grounding) في Vertex AI. أما AI Overviews وAI Mode فتُقدَّم من فهرس البحث الذي يبنيه Googlebot. وقد تكرر هذا الخطأ في القطاع كله منذ 2023.
والأداة الثالثة هي مجموعة الزواحف التي لم تسمع بها معظم ملفات robots.txt الإقليمية قط. فـ Meta-WebIndexer هو زاحف البحث في Meta AI، والمقابل المباشر لـ OAI-SearchBot، وهو غائب عن كل قوائم زواحف الذكاء الاصطناعي المنشورة تقريبًا. وقسّمت Amazon زاحفها Amazonbot إلى Amzn-SearchBot وAmzn-User. وتشغّل Anthropic ClaudeBot للتدريب، وClaude-SearchBot لفهرسة البحث، وClaude-User لعمليات الجلب التي يبدؤها المستخدم، وتعطيل Claude-SearchBot «قد يقلل ظهور موقعك ودقته في نتائج بحث المستخدمين». وPerplexityBot يُظهر المواقع ويربطها في نتائج Perplexity، وينبغي السماح له إن أردت الظهور هناك.
وقيدان عمليان يكملان الصورة. فقد وجد تحليل لمنظومة الاسترجاع في OpenAI أجرته شركة RESONEO ونُشر في أغسطس 2026 حدًا صارمًا لحجم الصفحة يبلغ 4 ميغابايت، تُرفض فوقه الصفحات كليًا بدلًا من اقتطاعها. وتنص إرشادات مشرفي المواقع في Bing على أن قيم lastmod في خريطة الموقع وIndexNow تؤثر مباشرةً في سرعة وصول التحديثات إلى الإجابات المولّدة بالذكاء الاصطناعي، بينما يُتجاهل changefreq وpriority.
ما تقوله الأدلة عما يحرّك الاستشهادات فعلًا
نشرت Google دليلها الخاص لتحسين الظهور في الذكاء الاصطناعي التوليدي في مايو 2026، وادعاؤه المركزي أنه لا يوجد تخصص منفصل. ويتناول الدليل مفردات القطاع مباشرةً، مسميًا تحسين محركات الإجابة (AEO) و تحسين محركات البحث التوليدية، ثم يقول: «من منظور بحث Google، التحسين للبحث بالذكاء الاصطناعي التوليدي هو تحسين لتجربة البحث، وبالتالي لا يزال SEO». ثم يسمّي خمسة أساليب شائعة ويطلب من أصحاب المواقع التوقف عنها.
إفصاح واحد قبل الأرقام. فكل دراسة استشهادات كبيرة في هذا المجال تقريبًا تنشرها شركة تبيع برمجيات لتحسين محركات البحث أو الظهور في الذكاء الاصطناعي: Ahrefs وSurfer وSemrush وSeer وProfound وPrevisible وRESONEO. ومنهجياتها مُفصح عنها عادةً وأحجام عيناتها حقيقية، لكن لا شيء منها محكّم، ولكلٍّ منها مصلحة تجارية في الاستنتاج. وحيث تأتي نتيجة أدناه من مزود له مصلحة مباشرة فيها، يُشار إلى ذلك. ووثائق Google هي المصدر الأولي الوحيد في هذا القسم.
أقوى ارتباط منشور في هذا المجال هو التفرع في الاستعلامات (query fan-out). يعرّفه دليل Google رسميًا بأنه «مجموعة من الاستعلامات المتزامنة وذات الصلة التي يولّدها النموذج»، ويضرب مثالًا باستعلام عن أعشاب الحديقة الضارة يتفرع إلى استعلامات فرعية عن مبيدات الأعشاب، والإزالة دون كيماويات، والوقاية. وحللت Surfer 10,000 كلمة مفتاحية و173,902 رابط و33,000 استعلام تفرعي في ديسمبر 2025، ووجدت أن الروابط المتصدرة عبر الاستعلامات التفرعية أكثر احتمالًا للاستشهاد بها بنسبة 161%، بمعامل ارتباط سبيرمان 0.77 بين ترتيب الاستعلامات التفرعية واستشهادات الذكاء الاصطناعي. وهذا أعلى ارتباط في أي دراسة رُوجعت لهذا المقال، ويتطابق مع وصف Google نفسها للآلية. فأنت لا تتصدر نتائج السؤال نفسه، بل نتائج الأسئلة الفرعية التي يتفرع إليها.
ذِكر العلامة التجارية يرتبط بالظهور في الذكاء الاصطناعي ارتباطًا أقوى بكثير من الروابط الخلفية. درست Ahrefs 75,000 علامة تجارية في مايو 2025 ووجدت أن ذِكر العلامة التجارية على الويب سجّل معامل سبيرمان 0.664 مقابل 0.218 للروابط الخلفية. وتُنسب هذه النتيجة مرارًا وخطأً إلى Seer Interactive في قطاع تحسين محركات البحث، بينما هي لـ Ahrefs. ويشير عمل Seer المنفصل في الاتجاه نفسه بشأن الروابط: فأقوى ارتباط أبلغت عنه نحو 0.65 لترتيب الصفحة الأولى في Google، بينما وجدت دراستها عن ذِكر العلامات في كبرى المواقع الإخبارية نحو 0.07، وهو ما وصفته Seer نفسها بأنه شبه انعدام للعلاقة.
ملفات المراجعات تُظهر أكبر قفزة قاسها أحد. حللت Seer Interactive وTrustpilot 804,491 إجابة ذكاء اصطناعي عبر 1,926 علامة تجارية و15,783 سؤالًا في مايو 2026، مع المطابقة حسب فئة تصنيف النطاق. العلامات التي لا تملك ملف مراجعات كان وسيط معدل الاستشهاد بها 1%، والعلامات ذات الملف الأدنى، أي من 1 إلى 13 مراجعة، بلغت 53.5%. الانتقال من لا شيء إلى شيء يرتبط بـ 52 نقطة مئوية، والانتقال من جيد إلى ممتاز يساوي نحو ست نقاط. وتحذيران يلازمان هذا الرقم: فـ Trustpilot شاركت في تأليف دراسة عن قيمة ملفات Trustpilot، والبيانات ارتباطية وذاتية الاختيار، لذا قد تختلف العلامات التي تجمع المراجعات عن غيرها بطرق لا تلتقطها مطابقة الفئات. ومع ذلك يبقى هذا البند أرخص ما في القائمة اختبارًا للعلامات الخليجية التي تكاد لا تملك حضورًا في المراجعات على المنصات الدولية.
والآن الأشياء التي لا تنجح، مع الأدلة ضد كلٍّ منها.
التصدر ضمن أفضل 10 نتائج في Google عامل تمكين أضعف مما يعتقده القطاع، والرقم تحرّك بحدة. أفادت Ahrefs في يوليو 2025 بأن 76% من استشهادات AI Overviews جاءت من صفحات ضمن أفضل 10. ثم حددت دراستها لـ 863,000 كلمة مفتاحية و4 ملايين رابط في AI Overviews، المنشورة في مارس 2026، النسبة بـ 37.9%، مع 31.2% من المراكز 11 إلى 100، و31.0% مما بعد المركز 100. أما في المساعدات المستقلة فلم تكن العلاقة قوية قط: فعبر 15,000 استعلام من الذيل الطويل، كان 12% فقط من استشهادات مساعدات الذكاء الاصطناعي ضمن أفضل 10 في Google، مع 8.0% لاستشهادات ChatGPT داخل النص، وPerplexity الاستثناء عند 28.6%. ولا يزال رقم 76% القديم يُعاد نشره على نطاق واسع، لذا تحقق من تاريخ أي نسخة تُعرض عليك.
ملف llms.txt لا يحقق أثرًا قابلًا للقياس. فحصت Ahrefs سجلات الخوادم لـ 137,210 نطاقًا في يونيو 2026. ومن بين الـ 28% التي تنشر ملف llms.txt، لم يتلقَّ 97% منها أي زيارة إليه في مايو 2026. ومن الطلبات التي وصلت، جاء 96% من روبوتات و19.5% فقط من أدوات ذكاء اصطناعي مسمّاة، وكانت أدوات تدقيق تحسين محركات البحث مسؤولة عن زيارات أكثر من مساعدات الذكاء الاصطناعي. ولم يُرصد أي روبوت ذكاء اصطناعي يبحث عن ملفات llms.txt غير موجودة. ويقول دليل Google صراحةً إنها «تتجاهلها»، وإن إنشاء ملف منها «لن يضر ولن يساعد ظهور موقعك أو ترتيبه في بحث Google». أنشئه إن شئت، لكن لا تعدّه من أساليب GEO.
ترميز Schema لا أثر مثبتًا له في الاستشهاد بالذكاء الاصطناعي. والدراسة المضبوطة الوحيدة تحليل «الفرق في الفروق» المطابق أجرته Ahrefs في مايو 2026، وغطى 1,885 صفحة أضافت JSON-LD بين أغسطس 2025 ومارس 2026، مقابل 4,000 صفحة ضابطة. النتيجة: AI Overviews انخفضت 4.6%، وAI Mode ارتفع 2.4%، وChatGPT ارتفع 2.2%، والأخيران لا يختلفان إحصائيًا عن الصفر. وقد قال Fabrice Canel من Microsoft إن Schema يساعد النماذج اللغوية لدى Microsoft على فهم المحتوى، وهذه حجة معقولة للإبقاء عليه. أما الادعاء بأن Schema من نوع FAQPage يجعل الذكاء الاصطناعي يستشهد بك فلا دليل أوليًا يدعمه على الإطلاق.
تقسيم محتواك إلى أجزاء إرضاءً للذكاء الاصطناعي ترفضه Google صراحةً: «لا يوجد أي شرط لتقسيم محتواك إلى قطع صغيرة ليفهمه الذكاء الاصطناعي فهمًا أفضل». والتوتر هنا حقيقي ويستحق الفهم. فالاسترجاع فعلًا على مستوى المقاطع. وقد أجرت Dejan AI هندسة عكسية لميزانية التأسيس لدى Google عبر 7,060 استعلامًا، بمراقبة المقتطفات المقدمة إلى Gemini عبر واجهة API المستندة إلى البحث، ووجدت نحو 2,000 كلمة مخصصة لكل استعلام، بوسيط 377 كلمة مختارة من كل صفحة مصدر، مع انهيار التغطية من 61% للصفحات دون 1,000 كلمة إلى 13% للصفحات فوق 3,000. وكان الاستنتاج «الكثافة تتفوق على الطول». فالاسترجاع على مستوى المقاطع، لكن الكتابة للمقاطع ليست ما يجعلها قابلة للاسترجاع، بل الصلة وكثافة المعلومات.
وتحذير آخر يُسقطه القطاع منهجيًا. فقد أبلغت ورقة GEO الأصلية من KDD 2024 عن مكاسب بنسبة 41% من إضافة الاقتباسات و31% من إضافة الإحصاءات. لكن هذه المكاسب قيست بين وثائق موجودة أصلًا في مجموعة الاسترجاع. فالورقة تصف كيف تفوز بحصة أكبر من الإجابة المولّدة حين تكون مرشحًا بالفعل، ولا تقول شيئًا عن السبيل إلى أن تصبح مرشحًا. ووجد مسح نقدي في 2026 أن التحسين المقتصر على نص الصفحة خفّض فعليًا الحضور ضمن أفضل 10 بعد إعادة الترتيب بنسبة 16% في أحد المعايير الشاملة.
قياس الظهور في الذكاء الاصطناعي من الخليج
تحسّن القياس كثيرًا في 2026، وأهم الأدوات لمنطقة الشرق الأوسط وشمال أفريقيا هي أقلها نقاشًا. فثلاث أدوات باتت تقدّم الآن بيانات حقيقية، ولكلٍّ منها قيد يجب أن تعلنه بوضوح قبل أن يبني أحد لوحة تحكم عليها.
أضافت Google Analytics 4 قناة رسمية لمساعدات الذكاء الاصطناعي في 13 مايو 2026. فباتت المُحيلات المعترف بها من مساعدات الذكاء الاصطناعي تُسند تلقائيًا إلى الوسيط ai-assistant والقناة «AI Assistant» في تقارير مجموعة القنوات الافتراضية. وبهذا تتقادم كل الشروح المنشورة في 2024 و2025 لبناء مجموعات قنوات مخصصة بالتعبيرات النمطية (regex)، وإن بقيت مفيدة لملء البيانات السابقة وللمساعدات التي لا تتعرف عليها Google. وتسمّي Google ChatGPT وGemini وClaude، ولم تنشر القائمة الكاملة لأسماء النطاقات التي تصنّفها. وتُلحق OpenAI utm_source=chatgpt.com بروابط الإحالة، وهو الوسم الوحيد للإحالة المؤكد من المزود.
أضاف Search Console تقارير أداء الذكاء الاصطناعي التوليدي في 3 يونيو 2026، تغطي AI Overviews وAI Mode عبر البحث وDiscover. والقيد شديد: لا يوجد مقياس للنقرات، بل مرات الظهور فقط. وتقول Google إنها «تواصل العمل مع أصحاب المواقع لفهم أنفع الرؤى والبيانات لتوجيه استراتيجياتهم».
يقدّم Bing Webmaster Tools أكثر بيانات القياس فائدةً على المستوى العملي في السوق، ولا يكاد يستخدمه أحد في المنطقة. فتقرير أداء الذكاء الاصطناعي فيه، المتاح معاينةً عامة منذ 10 فبراير 2026 والموسّع في يونيو، يتضمن «استعلامات التأسيس» (Grounding Queries)، التي تعرّفها Microsoft بأنها «العبارات الرئيسية التي استخدمها الذكاء الاصطناعي عند استرجاع المحتوى». أي الاستعلام التفرعي المعاد صياغته الذي استخدمه نظام الذكاء الاصطناعي فعلًا للوصول إلى صفحتك. ولا تتيح Google ولا OpenAI ذلك. وبما أن الترتيب في الاستعلامات التفرعية أقوى ما يرتبط بالاستشهاد مما قاسه أحد، فإن تقريرًا مجانيًا يُريك الاستعلامات التفرعية الفعلية أثمن من معظم أدوات الظهور في الذكاء الاصطناعي المدفوعة.
مشكلة الزيارات المظلمة أسوأ مما تعترف به معظم لوحات التحكم. فروابط الشريط الجانبي في Google AI Mode لا تمرر أي مُحيل على الإطلاق، لذا تصل تلك الزيارات على أنها زيارات مباشرة ويستحيل عدّها بنيويًا في GA4. وجلسات تطبيقات الجوال الأصلية من ChatGPT وPerplexity وClaude كثيرًا ما تصل دون مُحيل. ووجدت دراسة Previsible لـ 6.77 مليون جلسة مصدرها النماذج اللغوية عبر 166 خاصية GA4، المنشورة في يوليو 2026، أن ChatGPT يستحوذ على 92.4% من زيارات الإحالة القابلة للتتبع من النماذج اللغوية، ثم أضافت أهم تحذير في الدراسة: فهي تقيس إحالات النماذج اللغوية المستقلة فقط وتستبعد الاكتشاف بالذكاء الاصطناعي داخل نتائج Google نفسها، وهو ما يقول الباحثون إنه «يمثل على الأرجح حجمًا من الزيارات القادمة من الذكاء الاصطناعي أكبر من جميع منصات النماذج اللغوية المستقلة مجتمعةً».
استبدل تغيير في واجهة ChatGPT في مايو 2026 استشهادات الحواشي بأسماء علامات تجارية قابلة للنقر، فقفزت الإحالات إلى الصفحات الرئيسية من نطاق 26 إلى 32% إلى نحو 60% من زيارات الإحالة، وبقيت هناك. وفي تلك اللحظة انكسر الإسناد على مستوى الصفحة. فإن بدت بيانات صفحات الهبوط العربية لديك غريبة منذ مايو، فهذا هو السبب.
خطة 90 يومًا للظهور في الذكاء الاصطناعي بالعربية
الأيام من 1 إلى 15: الأهلية. دقّق ملف robots.txt بشأن OAI-SearchBot وClaude-SearchBot وPerplexityBot وMeta-WebIndexer وAmzn-SearchBot. وتأكد من ضبط إعداد الذكاء الاصطناعي التوليدي في Search Console على «التضمين» إن كانت قد طُرحت لخاصيتك. وتحقق من أن أي قالب عربي لا ينتج صفحات تتجاوز 4 ميغابايت. وتأكد من دقة قيم lastmod في خريطة الموقع وفعّل IndexNow.
الأيام من 16 إلى 30: خط الأساس. فعّل قناة AI Assistant في GA4 وتقارير الذكاء الاصطناعي التوليدي في Search Console. وسجّل في Bing Webmaster Tools وابدأ في جمع استعلامات التأسيس، التي تحتاج إلى سجل قبل أن تصبح مفيدة. وشغّل من 40 إلى 60 سؤالًا عربيًا حقيقيًا، باللهجة والفصحى، عبر ChatGPT وGoogle AI Mode وGemini وPerplexity، وسجّل من يُستشهد به. هذا هو خط الأساس العربي الوحيد لديك، لأنه لا توجد مجموعة بيانات عامة.
الأيام من 31 إلى 60: طبقة الأسئلة. خذ أهم 10 صفحات تجارية لديك وأعد بناء طبقة الأسئلة فيها بالمستوى اللغوي الذي يستخدمه عملاؤك: صياغات باللهجة الخليجية وصيغ بالعربيزي في عناوين H2 وبنود الأسئلة الشائعة، والفصحى في الإجابات. واستبدل الأرقام العالمية العامة بأرقام خاصة بالخليج: أرقام ساما، والهيئة العامة للإحصاء، وهيئة الاتصالات والفضاء والتقنية، وهيئة تنظيم الاتصالات والحكومة الرقمية، وDataReportal، بدلًا من المعايير الأمريكية. وهذا هو «الكسب المعلوماتي» الذي تصفه Google بأنه «وجهة نظر فريدة تبرز».
الأيام من 61 إلى 90: خارج الموقع. ابنِ ملف المراجعات، لأن امتلاك 1 إلى 13 مراجعة يساوي 52 نقطة مئوية من معدل الاستشهاد. وقدّم ذِكر العلامة التجارية على بناء الروابط، لأن الذِّكر يرتبط بمعامل 0.664 والروابط بـ 0.218. وارسم خريطة استعلاماتك التفرعية من تقرير استعلامات التأسيس في Bing، وابنِ المحتوى حول الاستعلامات الفرعية لا المصطلح الرئيسي.
ما لن تخبرك به المقالات الأخرى عن GEO بالعربية
ثلاثة أمور تترتب على الأبحاث أعلاه لا يقولها أحد في أي مكان آخر، والأول منها هو سبب وجود هذا المقال كله.
ميزة الـ 0.6%. يُصوَّر نقص تمثيل العربية عادةً على أنه مشكلة للناطقين بها، وهو كذلك. لكنه أيضًا أقل بيئات الاستشهاد تنافسًا في أي سوق كبير. فبالإنجليزية يملك الاستعلام ملايين الوثائق المرشحة، وتقترب القيمة الحدية لصفحة إضافية جيدة البنية من الصفر. أما بالعربية فتُقاس مجموعة المرشحين لاستعلام تجاري محدد غالبًا بالعشرات. والندرة نفسها التي تُضعف الإجابات العربية هي ما يرجّح استرجاع صفحة عربية واحدة عالية الجودة ترجيحًا لا يتناسب مع حجمها. والناشرون الذين يتحركون الآن ينافسون في رصيد محتوى شبه فارغ. وتُغلق هذه النافذة مع امتلاء هذا الرصيد، وهي تمتلئ ببطء: فحصة العربية في Common Crawl تحركت أقل من عُشري نقطة مئوية في ست سنوات.
مفارقة الفصحى. كل نموذج رئيسي قادر على العربية مُحسَّن لإنتاج مستوى لغوي ليس له أي متحدث أصلي. تقول Google إن Gemini يفهم أكثر من 16 لهجة ويجيب بالفصحى، وتُظهر المعايير أن دقة اللهجات أقل من الفصحى بـ 4.2 نقطة. والنتيجة أن إجابات الذكاء الاصطناعي العربية هي، بنيويًا، إجابات رسمية عن أسئلة غير رسمية. والعلامات التجارية التي تفوز ليست تلك التي تكتب أكثر العربية رسميةً، بل تلك التي تجسر بين المستويين في الصفحة نفسها، مطابقةً اللهجة عند الاسترجاع والفصحى عند الاستخراج.
فراغ القياس فرصة للمحتوى. قاست ثلاث دراسات كبيرة سلوك استشهادات الذكاء الاصطناعي عبر اللغات، ولم تقس أيٌّ منها العربية. فدراسة Profound لـ 3.25 مليار استشهاد تشمل الأسواق العربية لكنها تقدّم مزيج المنصات لا لغة المصدر. وهذا يعني أن أي علامة تجارية إقليمية مستعدة لإجراء دراسة منظمة على الأسئلة، ونشر المنهجية، وإتاحة البيانات، تصبح المصدر الأولي لسلوك الاستشهاد بالذكاء الاصطناعي بالعربية. فالبيانات الأصلية هي الأصل الوحيد في هذه الفئة الذي لا بديل له، والمجال بالعربية فارغ.
الأسئلة الشائعة
هل يتطلب التحسين للبحث بالذكاء الاصطناعي عملًا مختلفًا عن تحسين محركات البحث؟
الموقف الرسمي لـGoogle، المنشور في دليلها لتحسين الظهور في الذكاء الاصطناعي التوليدي في مايو 2026، هو أنه لا يتطلب ذلك: «التحسين للبحث بالذكاء الاصطناعي التوليدي هو تحسين لتجربة البحث، وبالتالي لا يزال SEO». وما يسميه القطاع تحسين محركات البحث التوليدية هو، في منصات Google، تحسين محركات البحث بمجموعة مختلفة من فحوص الأهلية. والفروق العملية الموجودة فعلًا هي تلك الأدوات، مثل وصول OAI-SearchBot وإعداد الذكاء الاصطناعي التوليدي في Search Console، وبنية المحتوى التي تجيب عن الاستعلامات الفرعية لا المصطلحات الرئيسية. وفي الأسواق العربية هناك فرق إضافي أهم من الاثنين: المستوى اللغوي، أي الفجوة بين طريقة سؤال الناس وطريقة إجابة النماذج.
هل ينبغي لعلامة تجارية خليجية أن تنشر بالعربية أم بالإنجليزية؟
بالاثنتين، لكن ليس بنسختين متطابقتين. فالمحتوى الإنجليزي ينافس في رصيد محتوى تكون فيه النماذج في أقوى حالاتها والمنافسة في أشدها، والمحتوى العربي ينافس في رصيد محتوى لا يتجاوز 0.6% من الويب، تكون فيه النماذج في أضعف حالاتها والمنافسة في أدناها. والخطأ هو التعامل مع العربية على أنها طبقة ترجمة فوق الموقع الإنجليزي. فالمحتوى العربي الأصلي، عن واقع السوق العربي، هو ما تُظهر المعايير باستمرار أن النماذج تتعامل معه أسوأ تعامل، ولذلك فهو أثمن ما يمكن تقديمه.
هل لا يزال ChatGPT Search يعمل بـ Bing؟
ليس على إطلاقه في 2026. فـ OpenAI تشغّل زاحفها الخاص، OAI-SearchBot، وحددت أبحاث شركة RESONEO المنشورة في أغسطس 2026، التي غطت 1,249 إجابة و88,000 نتيجة بحث، فهرسًا داخليًا إلى جانب عدة مسارات استرجاع تختلف حسب فئة الحساب ونوع الاستعلام. وأظهرت الروابط من ذلك الفهرس الداخلي تداخلًا بنسبة 1.5% فقط مع أفضل 20 نتيجة في Bing للاستعلامات نفسها، وإن كانت مسارات RESONEO الأخرى الملاحَظة تتداخل أكثر بكثير مع Google. وتكتفي OpenAI بالقول إنها «تتعاون أحيانًا مع مزودي بحث آخرين»، مسميةً Microsoft وShopify في وثائق الخصوصية دون تأكيد ما الذي يوفره كلٌّ منهما. تعامل مع أي ادعاء واثق بشأن فهرس ChatGPT، بما فيه هذا، على أنه مؤقت.
هل يساعد llms.txt في الظهور في الذكاء الاصطناعي؟
لا يوجد دليل على ذلك. فحصت Ahrefs سجلات الخوادم عبر 137,210 نطاقًا في يونيو 2026، ووجدت أن 97% من ملفات llms.txt المنشورة لم تتلقَّ أي زيارات في مايو 2026. وتنص وثائق Google على أن بحث Google يتجاهلها وأن نشر ملف منها «لن يضر ولن يساعد» الظهور. ولم تؤكد أي شركة ذكاء اصطناعي كبرى أن أنظمة الاسترجاع لديها تقرأ ملفات llms.txt من أطراف ثالثة.
كيف تتتبع زيارات الإحالة من الذكاء الاصطناعي في الخليج؟
استخدم قناة AI Assistant في GA4 التي أُطلقت في مايو 2026، وتقرير أداء الذكاء الاصطناعي التوليدي في Search Console لمرات الظهور، وBing Webmaster Tools لاستعلامات التأسيس. ثم ضع في الحسبان ما لا يلتقطه أيٌّ منها: فروابط الشريط الجانبي في Google AI Mode لا تمرر مُحيلًا، وجلسات التطبيقات الأصلية كثيرًا ما لا تمرر مُحيلًا، وSearch Console يقدّم مرات الظهور دون مقياس للنقرات. وأي خط أساس للظهور في الذكاء الاصطناعي بالعربية في 2026 يجب أن يُستكمل باختبار يدوي للأسئلة، لأنه لا توجد مجموعة بيانات عامة تغطي الاستعلامات العربية.
أي مساعدات الذكاء الاصطناعي تعمل فعلًا بالعربية؟
أُطلقت AI Overviews من Google في منطقة الشرق الأوسط وشمال أفريقيا وبالعربية عالميًا في مايو 2025. وأُطلق Google AI Mode في المنطقة بالإنجليزية في أغسطس 2025 وبالفصحى في 8 أكتوبر 2025. ويدعم Gemini العربية منذ مايو 2024، فيفهم أكثر من 16 لهجة ويجيب بالفصحى. وChatGPT متاح في معظم دول الجامعة العربية، بما فيها السعودية والإمارات ومصر وقطر والكويت، وإن لم تنشر OpenAI أي إعلان خاص بالعربية لـ ChatGPT Search. وتقبل واجهة API في Perplexity العربية لغةً في مرشح لغة البحث، لكن الشركة لم تنشر أي واجهة عربية أو إطلاق في المنطقة.
العمل مع VOCTOS
وفي الجانب المدفوع، فُتحت إعلانات ChatGPT في 11 دولة عربية في 7 سبتمبر 2026، وإن لم تُدرج السعودية والإمارات بعد، ولا تزال الفئات الخاضعة للتنظيم مغلقة. إليك قائمة الدول الحالية وما تعنيه لقطاعك.
ولمعرفة أولى النتائج المنشورة من معلنين جرّبوا هذه الإعلانات، وكيف تختبرها في الخليج ومصر، اقرأ دراسات حالة إعلانات ChatGPT: ما تكشفه النتائج المنشورة للمعلنين العرب.
تبني VOCTOS برامج الظهور في الذكاء الاصطناعي للعلامات التجارية في السعودية والإمارات، والسوق العربي الأوسع، جامعةً بين عمل الأهلية التقنية، والمحتوى العربي الأصلي، وتتبع الاستشهادات على مستوى الأسئلة عبر ChatGPT وGoogle AI Mode وGemini وPerplexity. والآليات التي تنطبق على أي لغة مشروحة في دليل GEO؛ وهذا المقال هو الجزء الذي لا ينطبق إلا على العربية. وخط الأساس العربي الذي لا ينشره أحد هو الأجدر بأن يُبنى أولًا.
هل تريد أن يصل
المزيد من الناس إلى موقعك؟
مكالمة استراتيجية
وتدقيق كامل للموقع

اقرأ أيضًا

مقال Bing’s AI Performance Report: What Gulf and Egyptian Brands Can See About Copilot Citations

مقال Google تنقل ملخصات الذكاء الاصطناعي لبحث العلامات التجارية إلى الجانب: ما الذي يجب أن تتابعه العلامات في الشرق الأوسط الآن

مقال كيف تظهر في ChatGPT ويرشّح شركتك في إجاباته؟
مقال اسمك في ChatGPT: سمعة الأفراد والتنفيذيين في الذكاء الاصطناعي
مقال كم تكلفة SEO في مصر والسعودية والإمارات في 2026؟
مقال ما المواقع التي تستشهد بها محركات الذكاء الاصطناعي؟ ماذا تعني دراسة شملت 288 إجابة للعلامات الخليجية
نتائج حقيقية
المزيد من النجاحات
SEO وGEO لـ Delta Medical Labs
 GEO
أكثر من مليون زيارة عضوية شهريًا، 159,200 كلمة مفتاحية في نتائج البحث، 5,570 صفحة يستشهد بها الذكاء الاصطناعي، و 1,186 ترتيبًا في المركز الأول بالسعودية.
SEO عربي وGEO ونشر مقالات الضيوف لـ VPNly
 SEO
65 ألف زيارة عضوية شهرية في الذروة، 55 مقال ضيف، و 149 صفحة يستشهد بها الذكاء الاصطناعي.
SEO وGEO لـ Ogaei Virtual Care
GEO
من 3 إلى 7,931 نقرة عضوية شهريًا خلال 7 أشهر، أكثر من 2.9 مليون ظهور، و أكثر من 40 كلمة مفتاحية في أفضل 10 نتائج على Google.
SEO لـ Eduverse
SEO
12× زيادة في زيارات البحث خلال 10 أشهر، 45% من الكلمات المستهدفة في أفضل 5 نتائج، و 55% في أفضل 10 نتائج.
شركات تثق بنا